Table des matières
Ouvrir table des matières
- Un collaborateur brillant qui bafouille
- Le décor : une boucle, des effets de bord, deux sorties
- Panne n°1 : la réponse vide → re-tirer, avec une relance
- Panne n°2 : l’appel d’outil malformé → réessayer, mais seulement si rien n’est commité
- Panne n°3 : le 500 de chargement à froid → du backoff, pas des rafales
- Panne n°4 : la mission est morte en détenant la bonne réponse
- On veut du code !
- Ce que j’en retiens
- Épilogue
Un collaborateur brillant qui bafouille
Travailler avec un modèle de langage local, c’est travailler avec un collaborateur brillant qui bafouille de temps en temps. Il vous sort trois analyses impeccables, et puis d’un coup : une réponse vide. Un appel d’outil à moitié formé. Une erreur 500 sortie de nulle part. Rien de reproductible, rien de corrélé à quoi que ce soit — juste le bruit de fond d’une machine probabiliste servie par un démon local.
Et si votre boucle d’agent traite chacun de ces bafouillages comme une erreur fatale, voici ce qui se passe : des missions entières meurent pour un glitch d’une seconde. J’en ai fait l’expérience quatre fois, quatre pannes différentes — dont une, ma préférée, où la mission est morte en détenant déjà la bonne réponse. Je vous la garde pour la fin, elle le mérite.
Cet article raconte ces quatre incidents dans l’ordre où ils ont mordu, et la politique de retry qui en est sortie : quand réessayer, comment, quand ne surtout pas réessayer — et quand l’erreur ne compte tout simplement plus. Si vous construisez une boucle d’agent, même modeste, ces quatre règles vous éviteront de payer les mêmes leçons au même prix.
Le décor : une boucle, des effets de bord, deux sorties
Plantons le décor en trois phrases. Un agent autonome tourne en boucle : le modèle prend une décision, la boucle exécute l’outil demandé, l’observation revient au modèle, qui décide de la suite. Certains outils ont des effets de bord — écrire un fichier, envoyer une notification : des choses qu’on ne peut pas « dé-faire » en relançant. Et deux outils terminaux clôturent la mission en livrant la réponse finale.
Les modèles, eux, sont des modèles open-weight locaux, servis par un démon type Ollama. Retenez deux propriétés de ce monde-là : c’est probabiliste (le même prompt peut réussir puis échouer), et c’est une machine qui charge et décharge des gigaoctets de poids en mémoire (le démon a ses humeurs). Ces deux propriétés vont chacune nous mordre.
Panne n°1 : la réponse vide → re-tirer, avec une relance
Premier incident. Le gros modèle renvoyait parfois son canal de réflexion… suivi d’un contenu vide. Pas d’erreur, pas de crash côté démon : une réponse, techniquement, mais sans rien dedans. Non déterministe, non corrélé à la taille du prompt — du bafouillage à l’état pur.
Et ma boucle, à l’époque, cassait à la première décision imparsable. Résultat : des missions qui avaient déjà produit deux rapports complets, tuées net par un tirage raté. Tout ce travail accompli, jeté, parce qu’un dé est mal retombé une fois.
D’où la règle n°1 : un tirage LLM raté n’est pas une panne. Une réponse vide ou imparsable, ça se re-tire — jusqu’à 3 fois, avec une consigne corrective ajoutée au prompt (« ta dernière réponse était vide, réponds avec une décision valide »). Un tirage raté, c’est le bruit de la machine ; trois de suite, c’est une panne. La distinction est toute bête, mais elle change la nature de la boucle : on arrête de traiter un phénomène probabiliste avec une logique binaire.
Panne n°2 : l’appel d’outil malformé → réessayer, mais seulement si rien n’est commité
Deuxième incident, sur le petit modèle cette fois : par intermittence, il émettait un appel d’outil incomplet — un nom sans arguments, un JSON tronqué. Le moteur le traitait en erreur fatale, et une mission de plus mourait pour un glitch.
Le réflexe naïf, c’est « facile, on relance toute l’exécution ». Et c’est un piège, le plus sournois de cette histoire : si un outil à effet de bord a déjà tourné — un fichier écrit, une notification partie — relancer l’exécution rejoue l’effet de bord. Votre retry devient un bug de duplication : deux fichiers, deux notifications, et personne ne comprend pourquoi.
D’où la règle n°2 : le retry doit connaître les effets de bord. L’exécution complète ne se relance que tant qu’aucune observation n’est au journal — c’est-à-dire tant que rien d’irréversible ne s’est produit. Et il se trouve — coup de chance structurel — que ce glitch d’appel malformé frappe à la première décision : le retry précoce le couvre donc intégralement, sans jamais risquer de rejouer quoi que ce soit. Quant aux appels one-shot sans outils (une simple génération de texte, zéro effet de bord), eux se réessaient sans condition.
Vous remarquerez le principe sous-jacent : c’est l’idempotence, le même souci exactement que dans mon article sur les quotas partagés — savoir ce qui a déjà été consommé avant de décider de refaire. Un retry qui ignore l’état n’est pas une protection, c’est une roulette.
Panne n°3 : le 500 de chargement à froid → du backoff, pas des rafales
Troisième incident, et celui-là, tout le monde le connaît sous une forme ou une autre. Première mission après un redémarrage du démon : « EOF (status 500) ». Le modèle était en train de se charger en mémoire — plusieurs gigaoctets, plusieurs secondes. Mes 3 retries tout neufs sont partis… en rafale. Les trois, dans la même fenêtre de chargement. Budget épuisé, mission échouée. Et une fois le modèle chaud : 5 essais, 5 succès.
Autant dire que la leçon s’écrit toute seule. Règle n°3 : un retry sans backoff ne couvre pas les pannes de charge. Trois tentatives instantanées contre une panne qui dure des secondes, c’est zéro retry — vous avez juste échoué trois fois plus vite. La parade est modeste : un délai linéaire entre les tentatives, base 3 secondes multipliée par le numéro d’essai. Rien de bien sorcier, pas d’exponentiel savant ni de jitter — juste assez d’attente pour que la cause transitoire ait le temps de se dissiper. Le délai entre essais fait partie de la politique de retry, pas du confort.
Panne n°4 : la mission est morte en détenant la bonne réponse
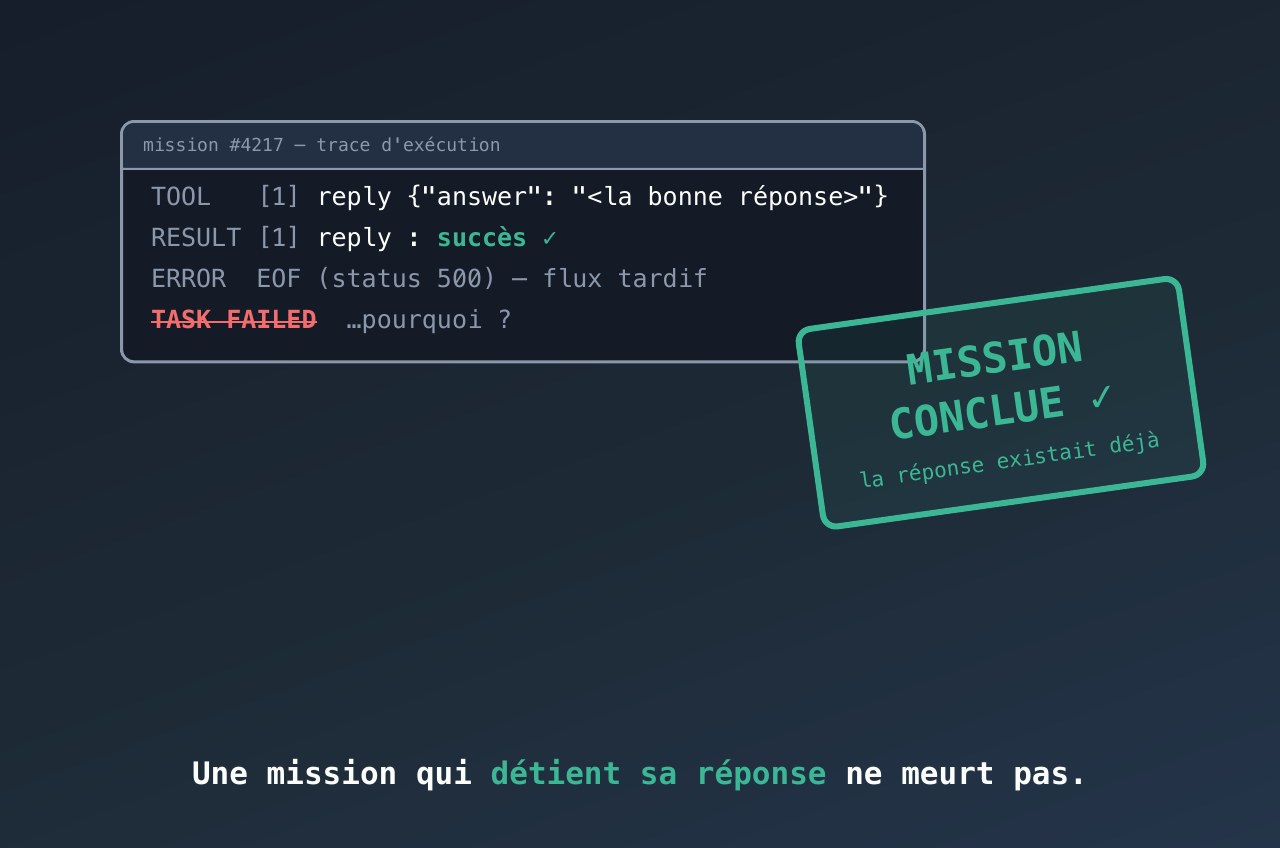
Et voici la vedette — le diagnostic le plus contre-intuitif des quatre, trouvé en lisant une trace d’exécution. Regardez-la, elle vaut le détour :
TOOL   [1] reply {"answer": "<la bonne réponse>"}   ← réponse émise
RESULT [1] reply : succès                            ← commitée
ERROR  EOF (status 500)                              ← erreur de flux tardive
TASK FAILED                                          ← ...pourquoi ?
Reprenons au ralenti. L’outil terminal reply a été appelé avec la réponse finale. Il a réussi — la réponse existe, elle est commitée au journal. Puis le flux du modèle a émis une erreur tardive (le modèle venait d’être évincé de la mémoire par le démon, son flux s’est fermé salement). Et cette erreur, arrivée après la fin utile de la mission, a fait échouer l’ensemble.
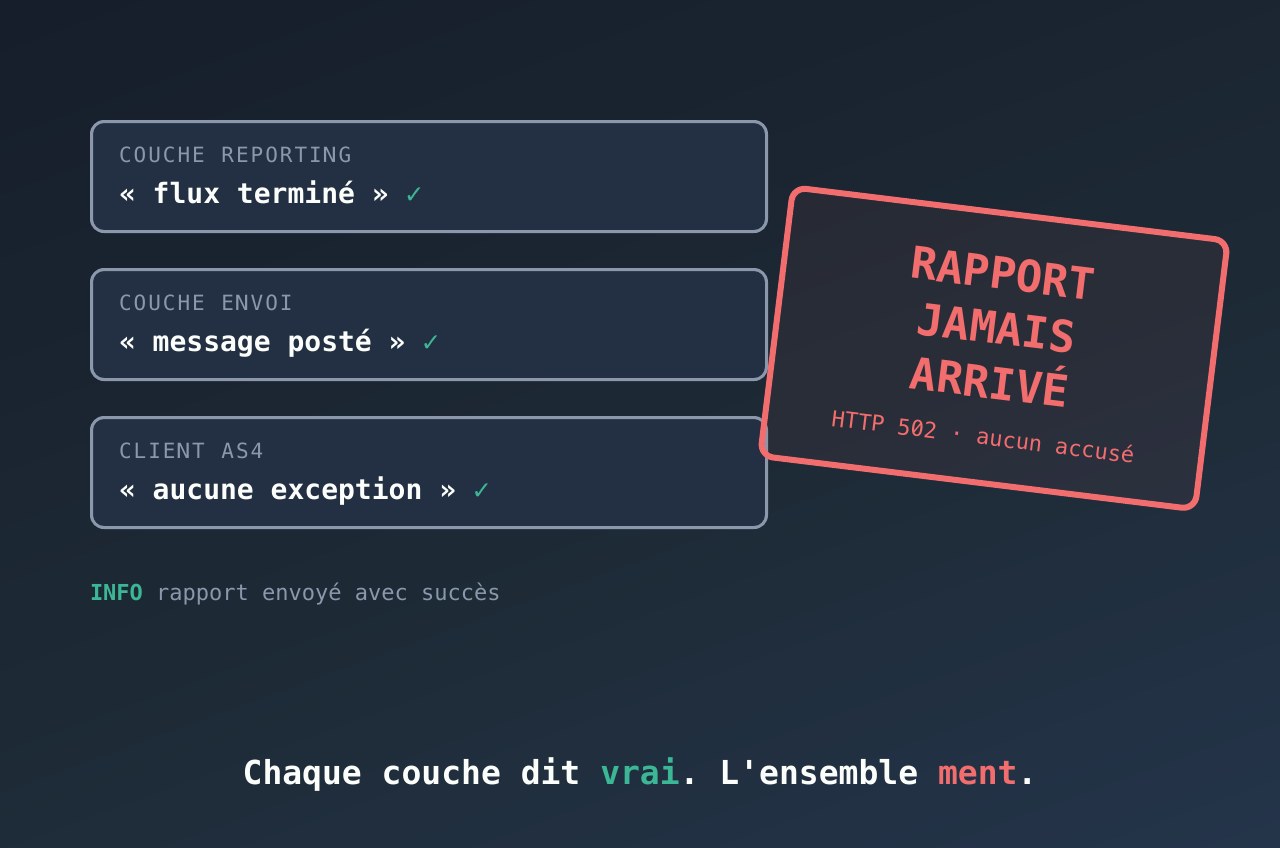
Le plus beau ? Ma règle n°2 a fonctionné exactement comme prévu : un effet de bord étant commité, elle a refusé de relancer — à raison. Chaque règle disait vrai localement, et la mission mourait quand même, en détenant la bonne réponse. Si vous avez lu mon autopsie d’un échec silencieux, vous reconnaissez la forme : des composants qui font chacun leur travail, et une composition qui produit l’absurde.
Règle n°4 : vérifier l’état avant de propager l’erreur. Le gestionnaire d’erreurs consulte l’état d’exécution avant de conclure quoi que ce soit : si un outil terminal a déjà réussi, toute erreur ultérieure est ignorée — du bruit de fin de flux — et la mission se conclut avec la réponse déjà produite. « Fini » doit être un état que le gestionnaire d’erreurs consulte, jamais une déduction du happy path.
On veut du code !
Les quatre règles tiennent ensemble dans un seul gestionnaire, et sa structure est plus parlante que tous mes paragraphes. Version générique, reconstruite pour l’exemple :
# Pattern générique : la politique d'erreur d'une boucle d'agent.
# L'ORDRE des tests est toute la politique.
try:
    async for event in engine.stream(run):
        ...
except EngineError as exc:
    if run.terminal_reached:
        # Règle 4 — un outil terminal a réussi : l'erreur tardive
        # est du bruit, la mission est FINIE, avec sa réponse.
        return Completed(run.terminal_payload)

    if run.observations:
        # Règle 2 — des effets de bord sont commités : rejouer
        # dupliquerait. On ne retente JAMAIS, on échoue proprement.
        raise

    if attempt < MAX_ATTEMPTS:
        # Règle 3 — panne de charge ≠ panne logique : on laisse
        # au transitoire le temps de se dissiper.
        sleep(BACKOFF_BASE * attempt)
        continue

    raise
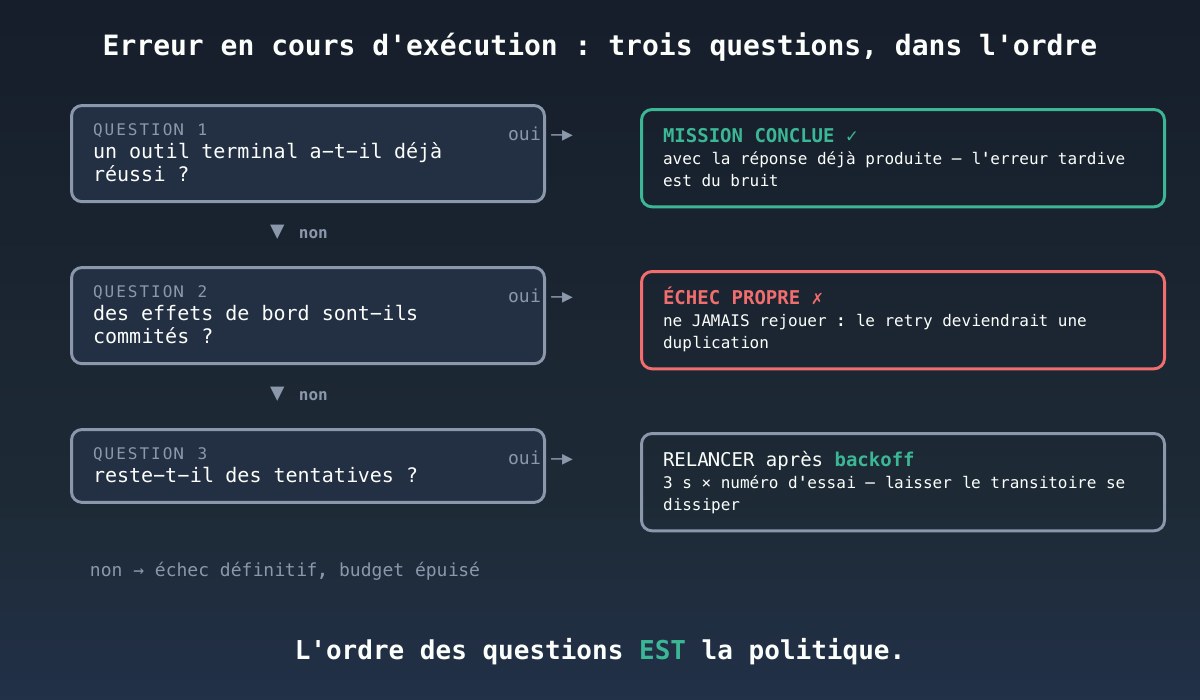
Ce petit bout de code fait exactement trois choses, dans un ordre qui ne doit rien au hasard. D’abord, il regarde si la mission est déjà finie — parce qu’une erreur après la fin ne dé-termine pas une mission. Ensuite, il regarde si quelque chose d’irréversible s’est produit — parce qu’un retry par-dessus un effet de bord est pire que l’échec. Et seulement alors, il retente, en attendant entre les essais. Inversez deux de ces tests et vous récoltez soit des missions mortes avec la bonne réponse en poche, soit des effets de bord dupliqués. L’ordre des if est la politique.
La règle n°1, elle, vit un cran plus haut — au niveau du tirage de décision, pas de l’exécution : re-tirer une décision imparsable (borné à 3, avec consigne corrective) avant même que la question de l’échec d’exécution ne se pose.
Ce que j’en retiens
Un tirage LLM raté n’est pas une panne. Le non-déterminisme est une propriété du composant, pas un incident : la boucle qui casse au premier parse raté jette du travail déjà accompli. Re-tirer, borné, avec consigne corrective — et seulement ensuite déclarer l’échec.
Le retry doit connaître les effets de bord. Relancer n’est sûr que tant que rien n’est commité au journal. Au-delà, le retry devient un bug de duplication — le genre qu’on découvre en production, en double. Les appels sans outils, eux, se réessaient sans condition : l’idempotence gratuite, autant la prendre.
Un retry sans backoff ne couvre pas les pannes de charge. Contre un chargement à froid de plusieurs secondes, trois tentatives en rafale valent zéro tentative. Le délai entre essais fait partie de la politique.
Vérifier l’état avant de propager l’erreur. Si le travail demandé est terminé, une erreur tardive de flux n’est pas un échec de la mission — c’est du bruit. C’est la leçon la plus générale des quatre, et elle dépasse largement les agents LLM : un gestionnaire d’erreurs qui ne consulte pas l’état d’exécution prend ses décisions à l’aveugle.
Vous noterez le fil commun : dans les quatre cas, la panne n’était pas dans le modèle — il bafouille, c’est sa nature. Elle était dans une boucle qui traitait toutes les erreurs pareil, sans se demander où en était le travail. La résilience d’un agent ne se joue pas dans le prompt ; elle se joue dans la machinerie d’erreurs, celle qu’on écrit sans y penser le premier jour et qu’on réécrit incident par incident.
Épilogue
Récapitulons le voyage : quatre pannes — la réponse vide, l’appel malformé, le 500 de chargement à froid, l’erreur de flux tardive — et quatre règles qui forment, ensemble, la politique d’erreur complète d’une boucle d’agent : re-tirer le probabiliste, ne jamais rejouer l’irréversible, espacer les tentatives, et consulter l’état avant de déclarer la mort. La plus précieuse est la dernière : une mission qui détient sa réponse ne doit jamais pouvoir échouer. Ça a l’air d’une évidence ; il m’a fallu une trace d’exécution sous les yeux pour la voir.
D’ailleurs, cette machinerie est exactement le genre de comportement durement acquis dont je parlais dans ma migration de moteur d’agent : chacune de ces règles est née d’un incident, et chacune est aujourd’hui un invariant numéroté, gardé par un test. Les leçons payées au prix d’un bug méritent mieux que la mémoire d’un développeur.
Et vous, qu’est-ce qui tue vos boucles d’agents ? Un glitch que je n’ai pas encore rencontré, une politique de retry plus maligne ? Racontez-moi ça en commentaire, je me ferai une joie de vous répondre — surtout si votre mission à vous est morte d’une façon encore plus absurde que la mienne.