Table des matières
Ouvrir table des matières
- Les règles de prompt lâchent au pire moment
- Le décor : une boucle, un orchestrateur, un vérificateur
- Bug n°1 : la mission se termine sur une intention
- Bug n°2 : le vérificateur déterministe a raison… hors contexte
- Le juge lui-même a un garde-fou : trois états, pas deux
- La grille : prompt, code, juge
- Ce que j’en retiens
- Épilogue
Les règles de prompt lâchent au pire moment
Il y a une croyance confortable quand on construit un agent LLM : « si je veux qu’il respecte une règle, je l’écris dans le prompt système ». C’est propre, c’est déclaratif, c’est au même endroit que le reste des instructions. Et sur un petit modèle local, c’est une illusion — pire : une illusion qui se dissipe précisément au moment où la règle compte le plus.
Je vais vous raconter deux bugs observés en conditions réelles sur mon agent local — un agent qui clôturait ses missions en annonçant le travail au lieu de le faire, puis un vérificateur déterministe qui rejetait à tort des livrables parfaitement conformes. Deux bugs aux antipodes : le premier m’a appris qu’une règle de prompt doit parfois descendre dans le code ; le second, qu’un contrôle codé doit parfois remonter vers un juge. De leur confrontation est sortie une grille de décision que j’utilise désormais systématiquement : quel garde-fou vit dans le prompt, lequel vit dans le code, lequel se confie à un juge LLM.
Le décor : une boucle, un orchestrateur, un vérificateur
Le contexte, pour ceux qui prennent l’histoire en route. Un agent autonome en boucle ReAct — le modèle choisit un outil, observe le résultat, recommence — sur des modèles open-weight locaux de taille modeste. Un mode orchestrateur décompose les demandes complexes en sous-tâches déléguées à des agents spécialisés, puis synthétise un livrable final. Et ce livrable est vérifié avant d’être rendu à l’utilisateur. C’est le même système que dans mes 600 tests verts — et d’ailleurs, les deux bugs du jour ont été trouvés exactement comme le promettait cet article-là : en campagne de test réelle, pas par la suite unitaire.
Gardez en tête le paramètre décisif : des modèles de taille modeste. Brillants par éclairs, économiques, locaux — et d’une fidélité aux instructions qui se dégrade à mesure que le contexte s’allonge. Toute la grille qui suit découle de cette réalité-là.
Bug n°1 : la mission se termine sur une intention
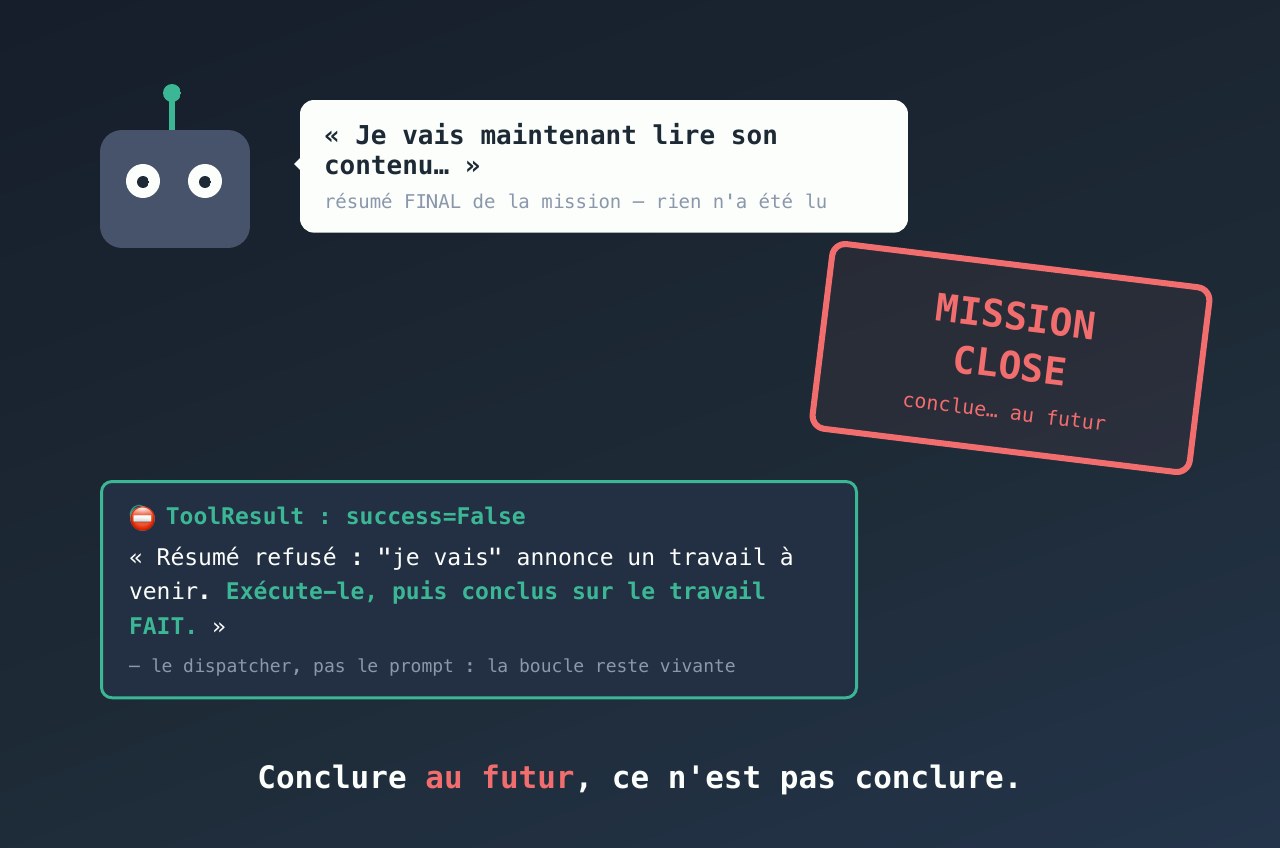
Observé deux fois le même jour, en usage réel. L’agent localise un document — jusque-là, parfait. Puis il appelle son outil de fin de mission avec pour résumé final : « Je vais maintenant lire son contenu… ». Mission close. Terminée, emballée, rendue à l’utilisateur. Rien n’a été lu.
Relisez-la, cette phrase de conclusion : elle est au futur. L’agent a conclu sa mission sur une intention — comme un artisan qui vous rendrait sa facture avec la mention « je vais maintenant faire les travaux ». Le plus troublant, c’est la cohérence interne : le modèle savait qu’il restait du travail, il l’a même annoncé. Il a juste… conclu quand même.
Première tentative : la règle dans le prompt
Réaction classique, la mienne comme celle de tout le monde : ajouter une règle au prompt système. « Un résumé final décrit du travail FAIT, jamais du travail à venir. » Clair, net, sans ambiguïté.
Le constat, après observation : sur un petit modèle, la règle tient pendant la boucle… et lâche à l’étape de conclusion. C’est-à-dire exactement l’étape qu’elle devait protéger. En fin de mission, le contexte est long, l’attention du modèle est diluée sur tout l’historique, et les instructions du prompt système sont loin derrière — c’est structurel, pas ponctuel. Une règle de prompt est une préférence que le modèle honore quand tout va bien ; ce n’est pas un invariant.
Le correctif qui a tenu : descendre d’un niveau
La solution est descendue du prompt vers le dispatcher d’outils — le code, déterministe, qui exécute chaque appel. Quand l’appel à l’outil terminal contient un idiome d’annonce — « je vais… », « laisse-moi… », « let me… » — l’outil de fin échoue, avec une erreur corrective. On veut du code ! Le voici, en pattern générique :
# Pattern générique : veto déterministe sur l'appel terminal.
# Un échec d'outil n'est pas fatal : il est renvoyé au modèle
# comme observation, et la boucle continue.
ANNOUNCE_IDIOMS = [r"\bje\s+vais\b", r"\blet\s+me\b", ...]  # serrés, exprès

def call_tool(name, args):
    if name in TERMINAL_TOOLS:
        phrase = detect_announcement(args.get("summary", ""))
        if phrase:
            return ToolResult(
                success=False,
                error=f"Résumé refusé : « {phrase} » annonce un travail "
                      f"à venir. Exécute-le, puis conclus sur le travail FAIT.",
            )
    return dispatch(name, args)
La mécanique est belle parce qu’elle recycle une propriété que la boucle possédait déjà : un échec d’outil n’est pas fatal, c’est une observation renvoyée au modèle — le même canal d’erreur métier que dans ma migration de moteur, celui qu’un spike avait validé dès le lot zéro. Le modèle reçoit « résumé refusé, exécute puis conclus », la boucle reste vivante, il lit réellement le document, et conclut sur du travail fait. La règle du prompt disait « ne fais pas ça » ; le dispatcher dit « ça ne peut pas se faire » — et laisse le modèle s’auto-corriger.
Un détail d’ingénierie mérite qu’on s’y attarde : les motifs de détection sont volontairement serrés — des idiomes d’annonce explicites, rien de plus. Pourquoi ne pas ratisser large ? Parce que le coût des erreurs est asymétrique : un faux positif coûte une reformulation (le modèle réécrit son résumé, dix secondes) ; mais un motif trop large rejetterait des résumés honnêtes en boucle — l’agent conclut, se fait refuser, reformule, se fait refuser… Mieux vaut rater un cas rare que fabriquer une prison. Calibrer un détecteur, c’est d’abord regarder ce que coûte chacune de ses erreurs.
Bug n°2 : le vérificateur déterministe a raison… hors contexte
Deuxième histoire, de l’autre côté du miroir. Le livrable final passait par deux vérifications : d’abord des contrôles déterministes — dont un compteur pour les contraintes chiffrées du brief, du genre « exactement 3 paragraphes » — puis un juge LLM sans outils, qui relit le livrable contre le brief.
En campagne réelle, un brief demandait entre autres « un message en exactement 3 paragraphes ». Le livrable, multi-parties, en faisait une trentaine au total — un rapport, des annexes, et le message demandé, qui faisait très exactement ses 3 paragraphes. Parfaitement conforme, donc.
Verdict du compteur : « à réviser ». Il comptait les paragraphes… du livrable entier. Trente n’est pas trois, rejet. Et chaque exécution repartait pour une re-synthèse coûteuse — un livrable correct, jeté et refait, parce qu’un compteur avait raison sur le mauvais périmètre.
La leçon a mis un moment à se formuler proprement, et la voici : un compteur ne sait pas lire une portée ; un juge, si. Une contrainte chiffrée dans un brief multi-parties porte presque toujours sur une sous-partie — « le message », « la conclusion », « le résumé ». Décider à quoi la contrainte s’applique est un acte de compréhension du texte, pas de comptage. Le code compte parfaitement ; il ne comprend rien.
Le correctif : les contraintes chiffrées ne sont plus jamais tranchées par le code. Elles sont injectées dans le prompt du juge comme checklist, avec la règle explicite : « une contrainte peut ne porter que sur une sous-partie du livrable ». Le contrôle déterministe, lui, ne conserve que ce qui est prouvablement global — comme la détection d’intention future du bug n°1, valable sur tout le texte quel que soit le contexte. Vous voyez la symétrie des deux bugs : le premier a fait descendre une règle du prompt vers le code ; le second a fait remonter un contrôle du code vers le juge. Chaque garde-fou a un étage naturel, et les deux bugs venaient d’un garde-fou logé au mauvais étage.
Le juge lui-même a un garde-fou : trois états, pas deux
Dernier étage de la fusée, et question qu’on oublie systématiquement : que se passe-t-il quand le juge ne peut pas rendre son verdict ? LLM indisponible, réponse imparsable — ça arrive, on l’a vu dans mes quatre pannes de boucle.
Le réflexe naturel — « pas d’objection = validé » — est un trou de sécurité. Un juge qui plante ne s’est pas abstenu d’objecter : il n’a pas regardé. Le verdict est donc ternaire : approuvé / à réviser / indisponible. Et « indisponible » n’est jamais traité comme une approbation implicite — c’est un état à part entière, visible, qui dit « ce livrable n’a pas été vérifié ». Les lecteurs de mon autopsie d’un échec silencieux reconnaîtront le principe fail-closed : un contrôle sauté se dit sauté, il ne se déguise jamais en contrôle passé.
Et un corollaire découvert en usage, que je vous livre parce qu’il est bête et universel : un verdict enregistré mais invisible n’existe pas. Mon vérificateur tournait consciencieusement à chaque exécution… et personne ne pouvait voir son verdict dans l’interface. Des semaines de vérifications rendues dans le vide. Un verdict doit être surfacé là où on regarde — sinon vous avez payé le calcul et perdu l’information.
La grille : prompt, code, juge
Récapitulons la grille de décision, celle que j’applique désormais à chaque nouveau garde-fou :
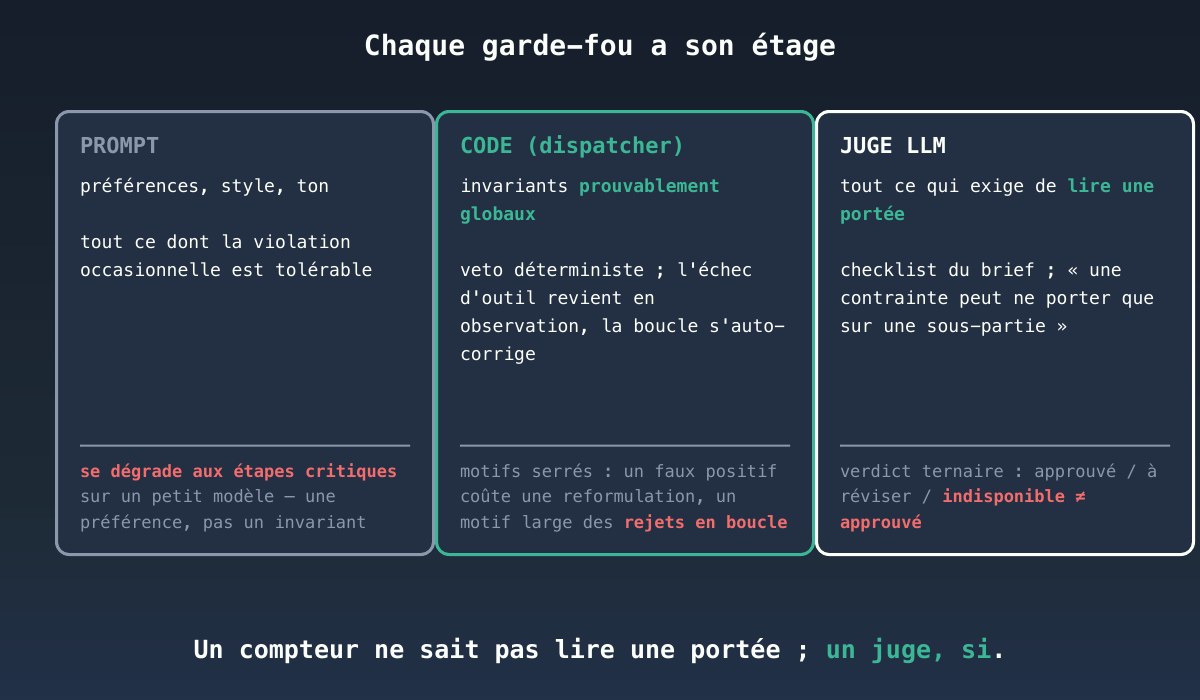
- Le prompt porte les préférences et le style — tout ce dont la violation occasionnelle est tolérable. C’est un étage utile, mais souvenez-vous : sur un petit modèle, il se dégrade aux étapes critiques.
- Le code (le dispatcher) porte les invariants prouvablement globaux — vrais sur tout le texte, dans tout contexte. Son veto est déterministe, et l’échec d’outil renvoyé en observation laisse la boucle s’auto-corriger. Motifs serrés, coût d’erreur asymétrique oblige.
- Le juge LLM porte tout ce qui exige de lire une portée ou comprendre un contexte — les contraintes du brief, chiffrées ou non. Avec son propre garde-fou : verdict ternaire, jamais d’approbation implicite, et un verdict surfacé là où on regarde.
Ce que j’en retiens
Les règles de prompt se dégradent aux étapes critiques. Sur un petit modèle, c’est à la conclusion — le moment même que la règle protégeait — qu’elle lâche. L’enforcement fiable vit dans le code : un appel terminal refusé garde la boucle vivante et laisse le modèle s’auto-corriger.
Un contrôle déterministe global ne vérifie que des contraintes prouvablement globales. Tout ce qui peut être scopé à une sous-partie du texte relève d’un vérificateur capable de lire la portée — un juge LLM avec checklist, pas un compteur. Le code compte ; il ne comprend pas.
Trois états, pas deux. Quand le vérificateur ne peut pas rendre de verdict, la réponse est « indisponible » — jamais un accord implicite. Et un verdict que personne ne voit n’existe pas : surfacez-le.
Calibrez les détecteurs sur le coût asymétrique des erreurs. Un faux positif du veto coûte une reformulation ; un motif trop large coûte des rejets en boucle. Serrez les motifs, acceptez de rater des cas — l’erreur bon marché est celle qu’on peut se permettre souvent.
Épilogue
Récapitulons le voyage : un agent qui concluait ses missions au futur, une règle de prompt qui lâchait exactement là où on l’attendait, un veto descendu dans le dispatcher ; puis un compteur qui rejetait des livrables conformes faute de savoir lire une portée, et sa contrainte remontée vers un juge ; enfin le juge lui-même, borné par un verdict ternaire et l’obligation d’être vu. Trois étages, trois natures de garde-fous — et une grille qui se résume en une question : cette règle exige-t-elle d’être toujours vraie, et faut-il comprendre le texte pour la vérifier ? Toujours vraie et vérifiable sans comprendre : le code. Toujours vraie mais contextuelle : le juge. Le reste : le prompt.
Rien de bien sorcier, une fois la grille posée — mais il aura fallu deux bugs en miroir pour la dessiner. C’est souvent comme ça que les architectures honnêtes naissent : pas d’un tableau blanc, mais de deux pannes qui se répondent.
Et vous, où vivent les garde-fous de vos agents ? Tout dans le prompt en croisant les doigts, ou avez-vous déjà déplacé une règle d’un étage à l’autre après une surprise en production ? Racontez-moi ça en commentaire, je me ferai une joie de vous répondre.