Table des matières
Ouvrir table des matières
- Le jour où mon code s’est retrouvé dans le checkout de quelqu’un d’autre
- Le décor : un SaaS qui veut des documents, une boutique qui vend
- Invariant 1 : le hook fait un INSERT, et rien d’autre
- Invariant 2 : les données hors périmètre ne voyagent jamais
- Invariant 3 : le cœur métier existe en un exemplaire… par préoccupation
- La décision d’auth : un plugin publié est un client public
- Ce que j’en retiens
- Épilogue
Le jour où mon code s’est retrouvé dans le checkout de quelqu’un d’autre
Pendant des années, j’ai écrit du backend. Mon code tournait sur mes serveurs, dans mes conteneurs, avec mes logs, mes retries, ma supervision. Quand ça cassait, ça cassait chez moi, et je le voyais.
Et puis j’ai dû écrire un plugin. Un vrai, distribué, qui s’installe dans la boutique en ligne d’un commerçant, sur une plateforme e-commerce du genre WooCommerce ou PrestaShop, pour dialoguer avec un SaaS. Et là, tout s’est inversé. Mon code ne tourne plus chez moi. Il tourne chez quelqu’un d’autre, sur un hébergement que je ne connais pas, avec une version de PHP que je n’ai pas choisie, à côté de quarante autres plugins dont j’ignore tout. Et pire : il s’exécute au beau milieu du parcours d’achat du client final de ce commerçant. Quelqu’un que je ne connais pas, qui achète quelque chose dont je ne sais rien, et dont la commande passe par mon code.
Autant dire que la question qui a guidé chaque décision de ce plugin n’a pas été « comment faire marcher ça ? », mais « que se passe-t-il quand ça casse, et qui en paie le prix ? ». Trois invariants d’architecture en sont sortis, plus une décision d’authentification qui va à contre-courant de tous les réflexes modernes. Je vous les déroule dans l’ordre où ils se sont imposés.
Le décor : un SaaS qui veut des documents, une boutique qui vend
Le besoin, généralisé : un SaaS doit recevoir des documents produits à partir des commandes d’une boutique en ligne. Chaque commande qui atteint un certain statut doit donner lieu à un document envoyé au service, qui le traite de son côté.
Le design naïf tient en une ligne : on s’accroche au hook « changement de statut de commande » de la plateforme, et on appelle l’API du SaaS. C’est ce que font beaucoup de plugins. C’est ce que j’aurais fait il y a dix ans, à l’époque où je bricolais encore des sites sous WordPress. Et c’est exactement ce qu’il ne faut pas faire.
Invariant 1 : le hook fait un INSERT, et rien d’autre
Commençons par comprendre où s’exécute un hook de statut de commande. Il s’exécute dans la requête HTTP de l’acheteur. L’acheteur clique sur « Commander », la plateforme traite le paiement, passe la commande au statut suivant, et déclenche les hooks abonnés à ce changement. Le vôtre est dedans. Tant que votre hook n’a pas rendu la main, l’acheteur attend.
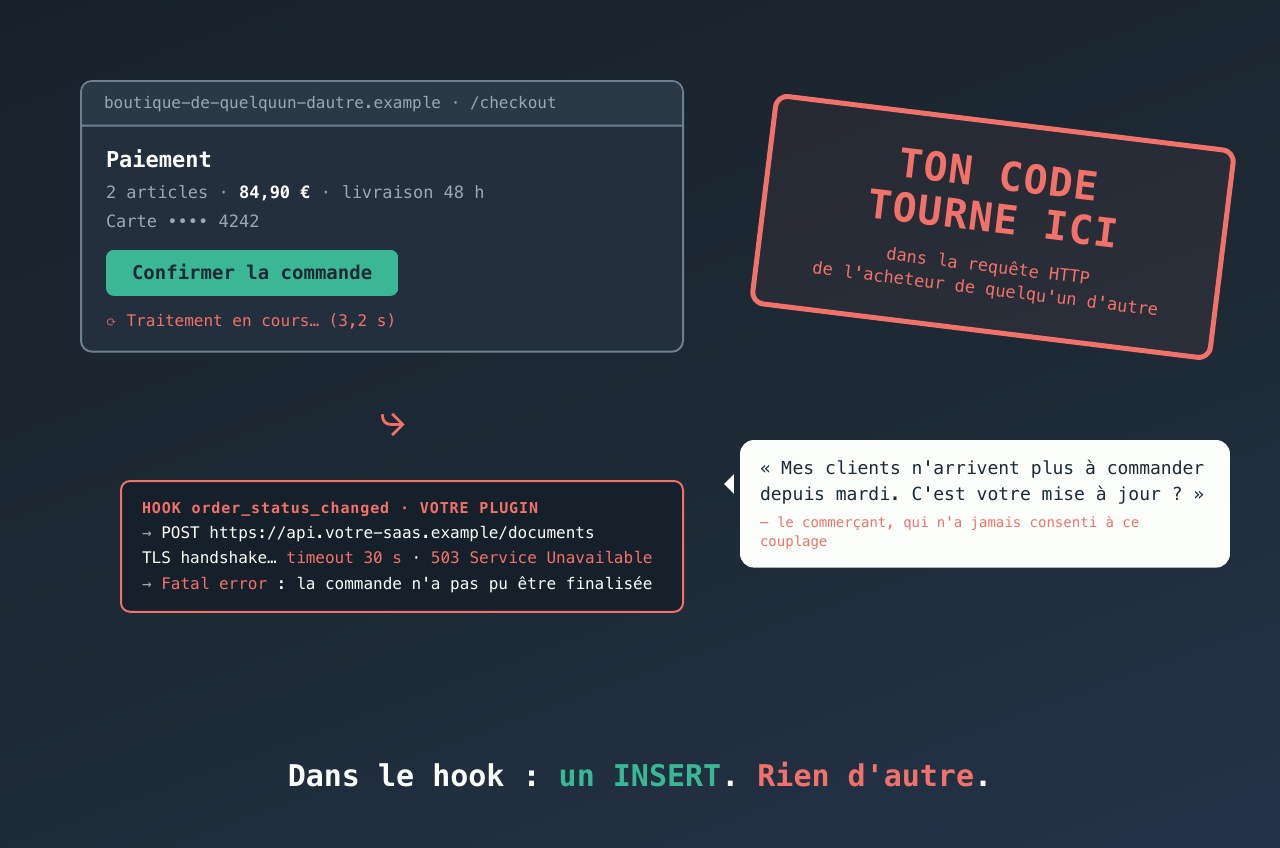
Maintenant, mettez un appel réseau sortant dans ce hook. Vous venez de coupler la disponibilité de votre SaaS, votre handshake TLS, la latence de votre file d’attente, et vos éventuels incidents, au checkout d’un commerçant qui n’a jamais consenti à ce couplage. Si votre API met trois secondes à répondre, l’acheteur attend trois secondes de plus. Si votre API tombe, et que le timeout est mal réglé, la requête de l’acheteur part en erreur. Le mode de défaillance à éviter n’est donc pas « le document part en retard ». C’est « la commande du client casse ». Et ce n’est pas une hypothèse d’école : un appel externe dans un hook de commande qui fait échouer des achats, c’est une classe d’incident bien connue de quiconque a lu les rapports de bug d’un écosystème e-commerce.
Le commerçant ne verra pas « le plugin X a un problème ». Il verra « mes clients n’arrivent plus à commander depuis mardi ». Et il aura raison d’être furieux.
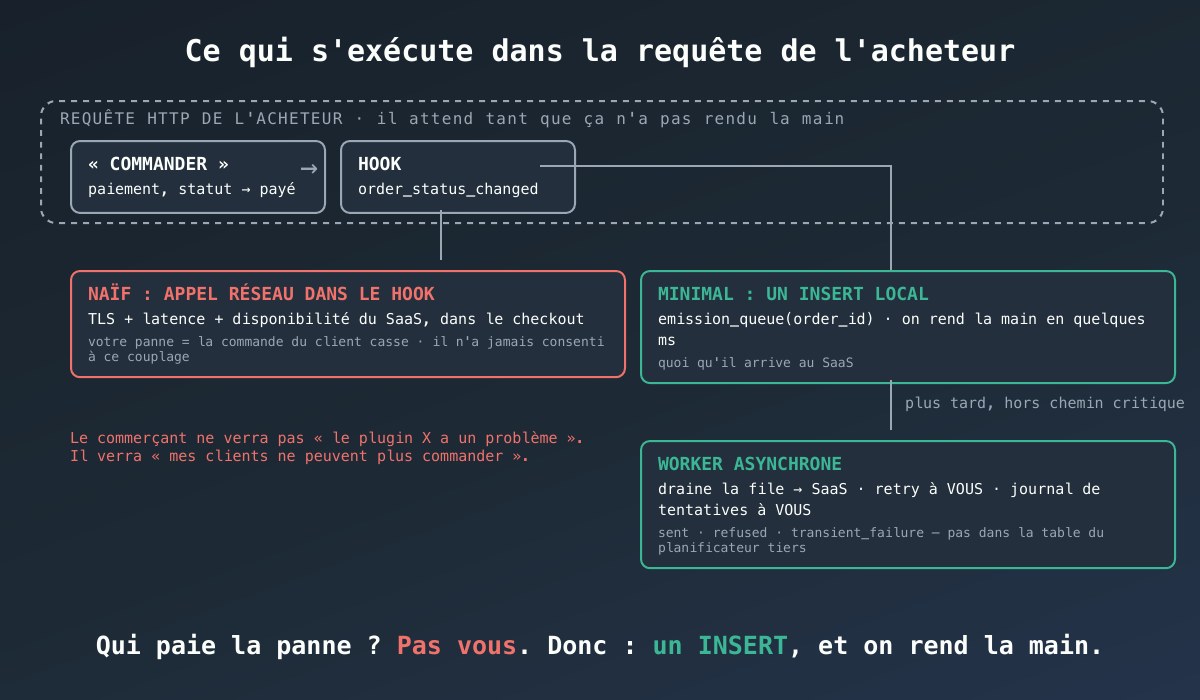
D’où le premier invariant : dans le hook, on fait le minimum vital, et le minimum vital, c’est une écriture locale.
// Le hook : une écriture LOCALE, puis on rend la main. Jamais de réseau ici.
function on_order_status_changed( int $order_id, string $from, string $to ): void {
    if ( ! Perimeter::is_in_scope( $order_id, $to ) ) {
        return; // hors périmètre : rien ne part, rien n'est appelé
    }
    EmissionQueue::enqueue( $order_id ); // un INSERT, c'est tout
}
Ce petit bout de code permet de rendre la main à l’acheteur en quelques millisecondes, quoi qu’il arrive à votre SaaS. Un INSERT dans une table locale de la boutique, et c’est fini. Un worker asynchrone, déclenché par le planificateur de tâches de la plateforme ou par un cron, viendra drainer cette file plus tard, hors du chemin critique.
Le retry et la trace d’échec vous appartiennent
Vous pourriez me dire : « mais la plateforme a déjà un planificateur de tâches, pourquoi une table à moi ? » Bonne question, et la réponse tient en deux propriétés que seul un état persistant local et à vous rend possibles.
Le retry vous appartient. Le planificateur embarqué d’une plateforme, quand il existe, exécute des tâches. Il ne réessaie pas tout seul une tâche qui a échoué selon votre politique à vous, avec vos délais, votre distinction entre échec transitoire et refus définitif. Si vous voulez un vrai retry, il faut le porter. C’est la même discipline que celle que je décrivais pour les étapes qui ne doivent jamais être fatales : distinguer « ça a échoué, on retentera » de « c’est refusé, on n’insiste pas », et c’est votre code qui doit le savoir.
La trace d’échec vous appartient. Le planificateur purge son historique selon sa politique de rétention, pas la vôtre. Si un échec d’émission est une pièce justificative, parce qu’un commerçant pourra un jour vous demander « pourquoi ce document n’est jamais parti ? », cette trace ne peut pas vivre uniquement dans la table d’un composant tiers qui la jettera quand bon lui semble. Le plugin tient donc son propre journal de tentatives.
-- Journal de tentatives du plugin, indépendant du planificateur de la plateforme.
-- Un échec d'émission est une pièce justificative, pas un log jetable.
CREATE TABLE {$prefix}emission_ledger (
    id          BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
    order_id    BIGINT UNSIGNED NOT NULL,
    attempt     SMALLINT UNSIGNED NOT NULL,
    outcome     ENUM('sent', 'refused', 'transient_failure') NOT NULL,
    detail      TEXT NULL,
    created_at  DATETIME NOT NULL
);
Trois issues possibles par tentative, et pas deux : sent, refused, transient_failure. La distinction entre les deux dernières est toute la politique de retry.
Un conseil de séquencement
Petit bonus, appris à mes dépens. Quand on vise plusieurs plateformes, commencez par celle qui possède une file de tâches. Portez ensuite vers celle qui n’en a pas. On conçoit bien mieux une abstraction de file depuis une implémentation qui marche que depuis une absence : la première vous montre ce dont vous avez vraiment besoin, la seconde vous fait inventer.
Invariant 2 : les données hors périmètre ne voyagent jamais
Deuxième inversion de réflexe. Le flux de commandes d’une boutique est, en majorité, hors du périmètre du service. Dans mon cas, le SaaS ne traitait que des échanges entre entreprises, alors qu’une boutique vend surtout à des particuliers. La plupart des commandes ne devaient donc donner lieu à rien.
Deux postures possibles.
La première : « on envoie tout, le serveur trie ». C’est tentant, parce que ça simplifie le plugin et centralise la logique. Mais regardez ce que ça produit : chaque boutique devient un flux de données personnelles de consommateurs (noms, adresses, e-mails) déversé vers un tiers qui n’en a aucun besoin. Et chaque refus côté serveur devient un ticket de support que le commerçant ne peut pas comprendre, puisqu’il ne voit qu’une erreur sur une commande qui, de toute façon, n’aurait pas dû partir.
La seconde, celle du plugin : filtrer là où la donnée habite. Une commande hors périmètre ne produit aucun appel réseau. Pas de document, pas de télémétrie, rien. Le filtre s’exécute dans la boutique, sur des données qui ne bougent pas. C’est le Perimeter::is_in_scope() du hook plus haut, et il rend la main avant même l’INSERT.
Et voilà le raffinement qui se rate facilement : même le compteur de commandes écartées reste local. « Vous avez eu N commandes hors périmètre ce mois-ci », ça a l’air anodin. C’est déjà une donnée business : le volume d’activité du commerçant. Et elle ne sert strictement à rien côté SaaS. Le chemin hors périmètre doit être entièrement observable par le commerçant, depuis son écran d’administration, et jamais observable par vous. La question de support « pourquoi cette commande a été sautée ? » se répond depuis l’écran du commerçant, avec des données qui n’ont jamais quitté sa boutique.
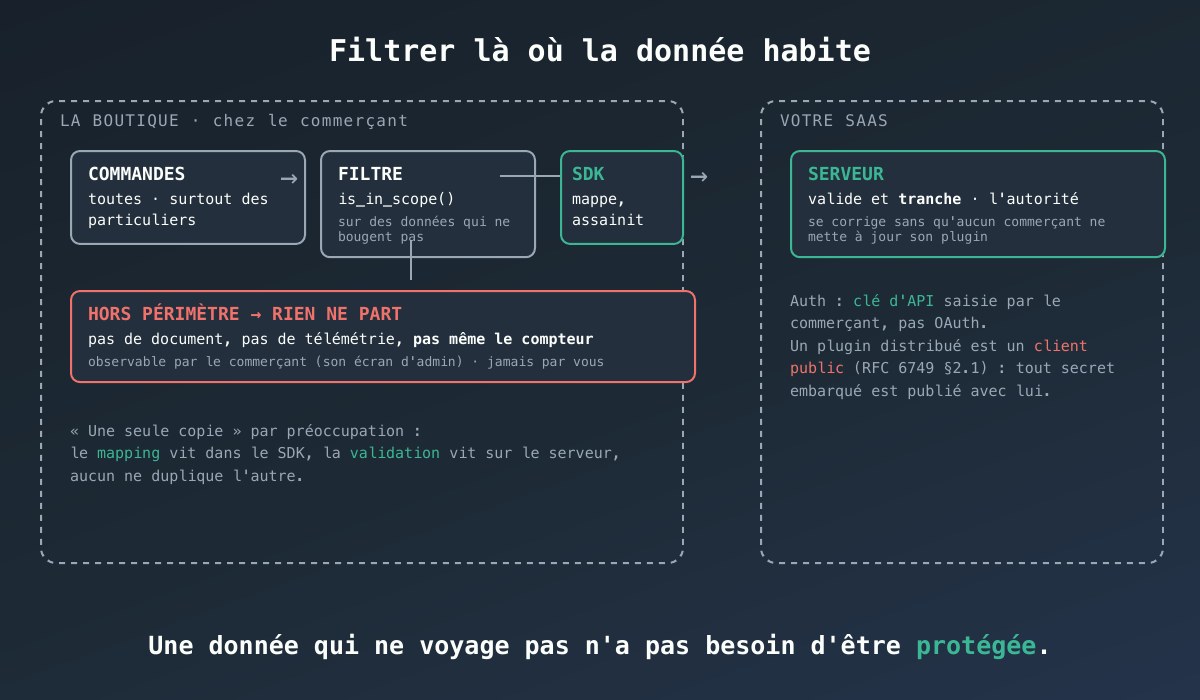
C’est, à mon sens, la version constructive du RGPD. J’ai écrit récemment sur ce que coûte d’effacer des données qu’on a collectées. La meilleure minimisation, c’est celle où la donnée ne part jamais. Une donnée qui ne voyage pas n’a pas besoin d’être protégée, justifiée, ni purgée. Vous n’avez pas à promettre de bien la traiter : vous ne l’avez pas.
Invariant 3 : le cœur métier existe en un exemplaire… par préoccupation
Troisième tentation, dès qu’on vise plusieurs plateformes : recopier le mapping commande → document dans chaque plugin. Après tout, les modèles de commande diffèrent, les hooks diffèrent, autant tout écrire deux fois.
Sauf qu’une correction de règle doit s’appliquer partout d’un coup. Avec deux copies, la seconde est fausse dès que la première est corrigée, et personne ne le voit. Jusqu’à l’audit d’un commerçant, six mois plus tard, qui se demande pourquoi ses documents ne ressemblent pas à ceux de son voisin.
Le découpage que j’ai retenu, et qui ne surprendra pas les habitués de mon architecture hexagonale :
- un SDK partagé porte le mapping, le traitement des taxes, l’idempotence ;
- chaque adaptateur de plateforme ne possède que ce qui lui est réellement spécifique : le nom du hook, le CRUD compatible avec son modèle de commande, la primitive de file, l’écran de réglages, les traductions.
// Adaptateur de plateforme : ne connaît que ce qui est spécifique à la plateforme
final class PlatformAdapter implements OrderSourcePort {
    public function load( int $order_id ): OrderSnapshot {
        $order = platform_get_order( $order_id );   // API native de la plateforme
        return OrderSnapshot::from_platform( $order ); // normalisation, pas de métier
    }
}

// SDK partagé : le métier, en un seul exemplaire pour toutes les plateformes
final class DocumentMapper {
    public function map( OrderSnapshot $order ): DocumentPayload {
        $lines = TaxRules::normalize( $order->lines() );
        return new DocumentPayload( $order->id(), $lines, Idempotency::key( $order ) );
    }
}
Et maintenant le raffinement qui garde cet invariant honnête, parce qu’il serait facile de le pousser trop loin : le SDK n’est pas un second validateur. Les contrôles qui font autorité restent côté serveur. Pourquoi ? Parce que le serveur s’exécute au dépôt et se corrige sans qu’aucun commerçant ne mette à jour son plugin. Une règle de validation dans le SDK, c’est une règle qui vivra dans des milliers d’installations, à des versions différentes, pendant des mois. Une règle sur le serveur, c’est une règle qu’on corrige un mardi et qui est en vigueur le mardi.
Donc : le SDK mappe et assainit, le serveur tranche. « Une seule copie » se raisonne par préoccupation, pas par emplacement. Le mapping a une seule copie, dans le SDK. La validation a une seule copie, sur le serveur. Et aucun ne duplique l’autre.
La décision d’auth : un plugin publié est un client public
Voilà la décision qui fait tiquer tout le monde en revue. Le réflexe moderne, quand on branche un connecteur sur une API, c’est OAuth. C’est propre, c’est standard, c’est ce que tout le monde attend. Et c’est le mauvais outil ici, pour des raisons mécaniques, pas idéologiques.
Premièrement, un plugin distribué est un client public. Le RFC 6749, celui qui définit OAuth 2.0, distingue dans sa section 2.1 les clients « confidentiels », capables de garder leurs identifiants secrets, des clients « publics », qui en sont « incapables », avec pour exemples une application native installée ou une application qui s’exécute dans le navigateur. Un plugin PHP téléchargeable par n’importe qui est exactement dans cette seconde catégorie : tout secret embarqué dedans est publié le jour où le plugin l’est. Les flux à client_secret sont donc hors jeu par construction, pas par choix.
Deuxièmement, les URIs de redirection. Un flux OAuth classique exige des URIs de redirection exactes, souvent revues par le fournisseur d’identité avant activation. Or chaque boutique vit sur son propre domaine. Onboarder un commerçant ne peut pas coûter une revue manuelle de son URL, sinon ce n’est plus un connecteur, c’est un processus manuel déguisé en connecteur.
Troisièmement, la durée de vie des jetons. Une famille de jetons de rafraîchissement à expiration absolue impose, tôt ou tard, un nouveau consentement de l’utilisateur. Pour un connecteur dont toute la promesse est de tourner sans surveillance, en tâche de fond, pendant des mois, le premier renouvellement raté est un arrêt silencieux. Le commerçant ne s’en apercevra que quand quelqu’un lui demandera où sont passés ses documents.
La réponse honnête, et un peu décevante pour qui aime les beaux protocoles : une clé d’API, créée par le commerçant dans son espace côté SaaS, et collée dans les réglages du plugin. Elle n’est pas embarquée dans l’artefact distribué : elle est saisie par le commerçant, dans sa boutique, et n’appartient qu’à lui. Elle se révoque en un clic. Et c’est le geste que tout l’écosystème pratique déjà : le commerçant qui a intégré n’importe quel autre service dans sa boutique connaît déjà le mouvement.
Ce n’est pas très différent de ce que je racontais à propos du bouton « Tester » qui ment : un intégrateur doit pouvoir se brancher seul, et comprendre seul ce qui se passe. Un protocole qui exige une revue par installation ou un re-consentement périodique lui retire cette autonomie.
Ce que j’en retiens
Dans le hook d’une plateforme tierce, faites le minimum vital : un INSERT local. Tout le reste s’exécute hors du chemin critique du client final. Et le retry comme la trace d’échec doivent vous appartenir, pas appartenir au planificateur du tiers, qui a sa propre politique de purge.
Filtrez là où la donnée habite. Une donnée qui ne voyage pas n’a pas besoin d’être protégée, justifiée, ni purgée. Et un compteur d’exclusions est déjà une donnée : il reste chez le commerçant, avec tout le reste.
Un plugin distribué est un client public. Concevez l’authentification en supposant que tout ce qui est embarqué dans l’artefact est lisible par tout le monde. Si votre protocole exige un secret embarqué ou une revue par installation, c’est le mauvais protocole pour ce canal.
« Une seule copie » se raisonne par préoccupation. Le SDK possède le mapping, le serveur possède la validation, et aucun ne duplique l’autre. Le serveur reste l’autorité parce que lui seul se corrige sans attendre que des milliers d’installations se mettent à jour.
Épilogue
Récapitulons. Un plugin qui tourne chez quelqu’un d’autre, dans le checkout de quelqu’un d’autre encore. Un hook qui ne fait qu’un INSERT et rend la main, avec un worker, un retry et un journal qui sont à vous. Un filtre qui s’exécute là où la donnée habite, pour que le hors-périmètre ne quitte jamais la boutique, compteur compris. Un SDK qui porte le métier en un exemplaire, sans jouer les validateurs. Et une clé d’API plutôt qu’OAuth, parce qu’un artefact distribué ne peut pas garder de secret.
Rien de tout ça n’est sorcier. Ce qui change, c’est le point de vue : chaque décision a été prise en se demandant qui paierait la panne. Et la réponse, presque à chaque fois, était « pas moi ». C’est là que le métier de développeur backend cesse d’être confortable, et devient intéressant.
Et vous, avez-vous déjà écrit du code qui tourne chez vos utilisateurs plutôt que sur vos serveurs ? Un plugin, une extension, un agent installé ? Qu’est-ce que ça a inversé dans votre façon de concevoir ? Racontez-moi ça en commentaire, je me ferai une joie de vous répondre.