Table des matières
Ouvrir table des matières
Un agent poussif, sans aucune raison visible
Mon agent local était devenu poussif. Pas cassé, pas en erreur — poussif. Chaque décision de la boucle, même la plus triviale, prenait un temps interminable. Choisir un outil, formater trois paramètres : le genre de micro-décision qu’on attend en une seconde ou deux… et qui en prenait cent.
Aucune erreur dans les logs, aucune surcharge machine, aucun prompt anormalement gros. Juste un agent qui rame, et un développeur qui commence par soupçonner tout le monde sauf le vrai coupable — le réseau, le démon, la taille du contexte, la lune.
Le coupable, le voici : les modèles open-weight récents réfléchissent par défaut. Cette fameuse « chaîne de pensée » qui améliore leurs réponses complexes, ils la déroulent aussi — intégralement, laborieusement — pour décider d’appeler un outil évident. Et sur une boucle d’agent qui enchaîne des dizaines de décisions, cette réflexion se paie à chaque étape.
Cet article, ce sont mes mesures (un ×25 sur un appel trivial, rien que ça), et surtout les deux pièges non évidents du réglage — dont un qui va vous surprendre : omettre le paramètre ne désactive rien.
Le décor : une boucle ReAct, deux étages de modèles
Le contexte, rapidement. Un agent autonome local en boucle ReAct : à chaque étape, un appel LLM décide du prochain outil, avec une sortie JSON courte et contrainte — du routage, pas de la littérature. Les modèles sont servis via Ollama, en deux étages : un petit modèle rapide pour le routage et la planification, un gros modèle pour le raisonnement lourd. C’est la même mécanique dont je vous parlais dans ma politique de retry d’une boucle d’agent — aujourd’hui, on s’attaque à sa lenteur.
Les deux familles de modèles supportent le « thinking » natif : le champ think de l’API de chat, documenté publiquement chez Ollama 🔗. Retenez-en deux faits, ils vont structurer toute la suite : la plupart des modèles acceptent un booléen (true/false) ou un niveau d’effort (low, medium, high…), et — c’est écrit noir sur blanc dans la doc — le thinking est activé par défaut sur les modèles qui le supportent.
La mesure qui fait mal
Avant d’accuser, on mesure. Voici ce que donnait un appel de planification trivial — le modèle rapide devant choisir un outil qui s’imposait de lui-même :
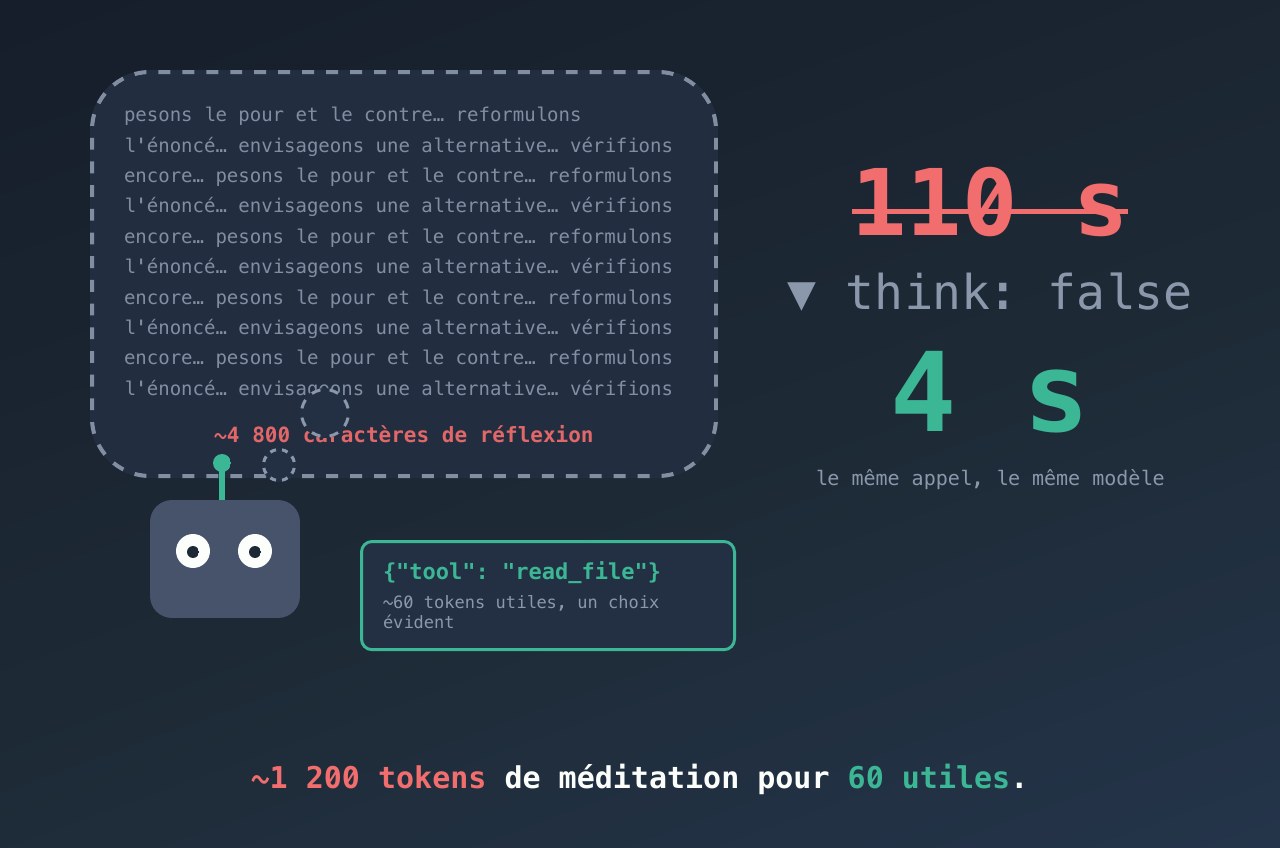
- ~1 273 tokens générés au total, dont ~4 800 caractères de chaîne de pensée ;
- pour ~60 tokens de JSON utile — la décision elle-même ;
- soit ~110 secondes d’appel… contre ~4 secondes une fois le thinking coupé.
Relisez ce ratio : environ 1 200 tokens de réflexion pour 60 tokens utiles. Le modèle rapide méditait longuement — pesait le pour, le contre, reformulait l’énoncé, envisageait des alternatives — pour aboutir à la décision qu’un if aurait prise. Plus de 95 % du temps de chaque étape partait dans une réflexion qui n’améliorait rien : sur un routage d’outil au format contraint, la « bonne réponse » est la même avec ou sans méditation.
Autant dire que sur une boucle qui enchaîne des dizaines de ces décisions, c’est la différence entre un agent utilisable et un agent qu’on n’attend plus. Le remède semble trivial — « on coupe le thinking et le tour est joué » — et c’est là que les deux pièges attendent.
Piège n°1 : omettre le paramètre, ce n’est pas désactiver
Le réflexe naturel de tout développeur : « je n’envoie pas le champ think, donc pas de thinking ». Ça paraît de bon sens — pas demandé, pas exécuté.
Eh bien non. Sur un modèle dont le thinking est activé par défaut, champ omis = comportement par défaut = réflexion à plein régime. L’absence du paramètre ne dit pas « non » : elle dit « comme tu veux » — et le modèle veut réfléchir. Seul un think: false explicite coupe réellement la réflexion.
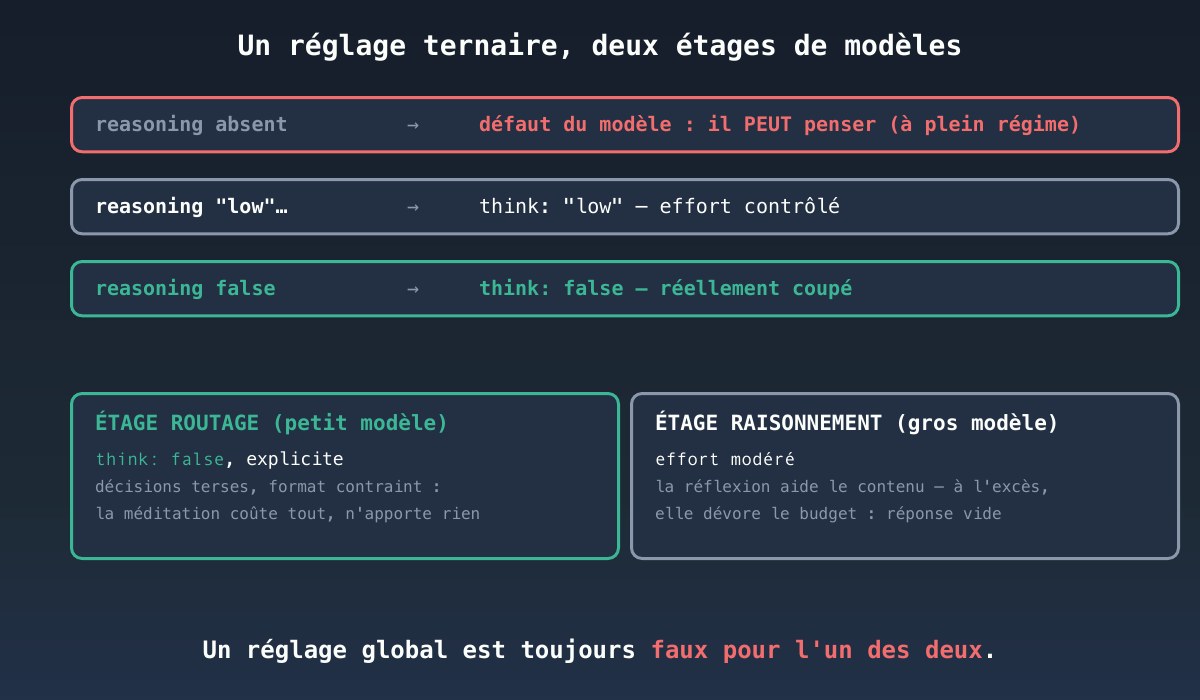
La conséquence en termes de configuration est plus profonde qu’il n’y paraît : le réglage n’est pas booléen, il est ternaire. Trois états, trois comportements distincts :
reasoning absent   → champ think omis   → défaut du modèle (peut penser !)
reasoning "low"…   → think: "low"       → effort contrôlé
reasoning false    → think: false       → réellement coupé
Et ce ternaire m’a offert un bonus vicieux, que je vous livre en confession. Mon code transmettait le réglage avec le test le plus naturel du monde :
# AVANT — le bug : False est falsy, donc "couper le thinking"
# ne part JAMAIS sur le réseau. Le défaut du modèle s'applique.
if reasoning:
    payload["think"] = reasoning

# APRÈS — le trois-états impose de distinguer « absent » de « False ».
if reasoning is not None:
    payload["think"] = reasoning
Vous voyez le piège ? En Python, False est falsy : mon if reasoning: avalait silencieusement la valeur False, qui n’atteignait jamais le client HTTP. Je croyais couper le thinking, le champ n’était même pas envoyé, et le modèle continuait de méditer — le réglage le plus important du fichier de config était un no-op. Un ternaire déguisé en booléen, c’est deux bugs pour le prix d’un : celui qu’on voit (omettre ≠ désactiver) et celui qu’on ne voit pas (la plomberie qui avale False).
Piège n°2 : trop de réflexion produit… une réponse vide
Deuxième piège, sur le gros modèle cette fois, et celui-là est presque poétique. Puisque le thinking améliore le raisonnement, pourquoi ne pas pousser l’effort au maximum sur l’étage de raisonnement lourd ? Plus de réflexion, meilleures réponses, non ?
Non. Et la raison tient en une phrase qu’il faut avoir lue une fois : les tokens de réflexion comptent dans le budget de génération. La chaîne de pensée et la réponse finale puisent dans la même enveloppe. Sur une étape chargée — gros prompt système, grosse observation — la réflexion à effort maximal épuisait le budget avant le premier token de réponse. Résultat : des milliers de caractères de méditation, et un contenu… vide. Échec de parsing, étape perdue.
Je l’ai reproduit empiriquement, à froid : petit budget de génération + effort maximal → zéro contenu, systématiquement. Si vous avez lu mes quatre pannes de boucle d’agent, vous vous souvenez de la panne n°1 — la réponse vide intermittente. Eh bien voici l’une des façons de se la fabriquer soi-même, proprement, par excès de zèle de configuration.
Deux parades en sont sorties. Un garde-fou : si l’effort de réflexion était réglé et que le contenu revient vide, réessayer une fois sans le champ — on perd la réflexion, on sauve l’étape. Et un ajustement de doctrine : le réglage de croisière du gros modèle est redescendu d’un cran. La réflexion profonde aide la production de contenu — analyser, rédiger, synthétiser. Elle n’aide en rien le routage laconique d’outils, et à l’excès, elle le sabote.
La règle qui reste : régler par étage
Au bout de ces deux pièges, la règle finale est d’une simplicité désarmante : l’effort de réflexion se règle par étage et par type de tâche, jamais globalement.
- Petit modèle de routage : thinking coupé —
think: false, explicite. Les décisions sont terses, le format est contraint, la méditation n’apporte rien et coûte tout. - Gros modèle de raisonnement : effort modéré. Assez pour la qualité du contenu, pas assez pour dévorer le budget de sortie.
Un seul réglage global est toujours faux pour l’un des deux étages : coupé partout, vous dégradez le raisonnement lourd ; activé partout, vous paralysez le routage. C’est le même principe de fond que dans ma migration de moteur d’agent, où un spike avait déjà révélé que la règle de thinking change par famille de modèle : ces réglages-là sont des invariants par étage, pas des préférences globales — et ils méritent d’être écrits, testés, et protégés de la « simplification » d’un futur refactoring.
Et le résultat, pour finir de vous convaincre : l’appel de planification trivial est passé de ~110 secondes à ~4 secondes. Sans changer une ligne de prompt, sans changer de modèle, sans toucher au matériel. Juste en cessant de payer une réflexion dont personne n’avait l’usage.
Ce que j’en retiens
Mesurez le ratio réflexion/utile. ~1 200 tokens de chaîne de pensée pour ~60 tokens de décision : le thinking par défaut peut consommer plus de 95 % du temps d’une boucle d’agent sans améliorer une seule décision. Tant que vous n’avez pas mesuré ce ratio sur vos propres appels, vous ne savez pas ce que votre agent paie.
Omettre n’est pas désactiver. Sur un modèle thinking-ON par défaut, seul un false explicite coupe la réflexion. Et le réglage est ternaire — absent / niveau / coupé — pas booléen : méfiez-vous des plomberies qui avalent False comme falsy. Le is not None n’est pas de la pédanterie, c’est le bug.
La réflexion consomme le budget de sortie. Effort trop haut + étape chargée = réponse vide. Prévoyez le garde-fou de re-tentative sans thinking, et réservez l’effort haut à la génération de contenu.
Réglez par étage. Routage : coupé. Raisonnement lourd : modéré. Tout réglage global est faux pour l’un des deux — et cette asymétrie est un invariant de votre système, pas un détail de config.
Épilogue
Récapitulons le voyage : un agent poussif, une mesure qui désigne le coupable (~1 200 tokens de méditation pour choisir un outil évident), et deux pièges de réglage — l’omission qui ne désactive rien, l’excès qui produit du vide. La sortie : un réglage ternaire transmis sans se faire avaler, un garde-fou de re-tentative, et une doctrine par étage. Bilan : ×25 sur chaque décision de routage, pour zéro ligne de prompt modifiée.
Ce que j’aime dans cette histoire, c’est qu’elle est un condensé du travail avec les LLM locaux : le comportement par défaut n’est pas neutre, la doc mérite d’être lue jusqu’au bout, et la performance se joue parfois dans un champ d’API à trois états. Rien de bien sorcier — à condition de savoir que c’est là.
Et vous, avez-vous mesuré ce que le thinking coûte à vos agents ? Un ratio encore pire que le mien, un piège de réglage que je n’ai pas croisé ? Racontez-moi ça en commentaire, je me ferai une joie de vous répondre — chiffres à l’appui si possible, c’est encore mieux.