Table des matières
Ouvrir table des matières
- Un compte qu’on ne peut plus effacer
- Le décor : effacer, c’est une obligation… et une preuve
- Le jour où la baleine est arrivée
- Le diagnostic : trois anti-patterns qui ne font pas mal à petite échelle
- Pourquoi je ne pouvais pas « juste » optimiser
- On veut du code !
- La prise accessoire : un job qui échouait depuis des semaines
- Ce que j’en retiens
- Épilogue
Un compte qu’on ne peut plus effacer
Effacer un compte, c’est facile. Enfin, c’est facile quand le compte est petit.
Laissez-moi vous raconter l’histoire d’une purge RGPD qui marchait très bien, qui avait ses tests, qui avait été relue, et qui est devenue du jour au lendemain incapable de faire la seule chose pour laquelle elle existait : effacer. Pas à cause d’un bug, au sens où personne n’avait écrit une ligne fausse. À cause d’un client. Un gros. Le genre de client qu’on appelle une « baleine » : des dizaines de milliers d’entités sous un seul compte, en route vers des centaines de milliers.
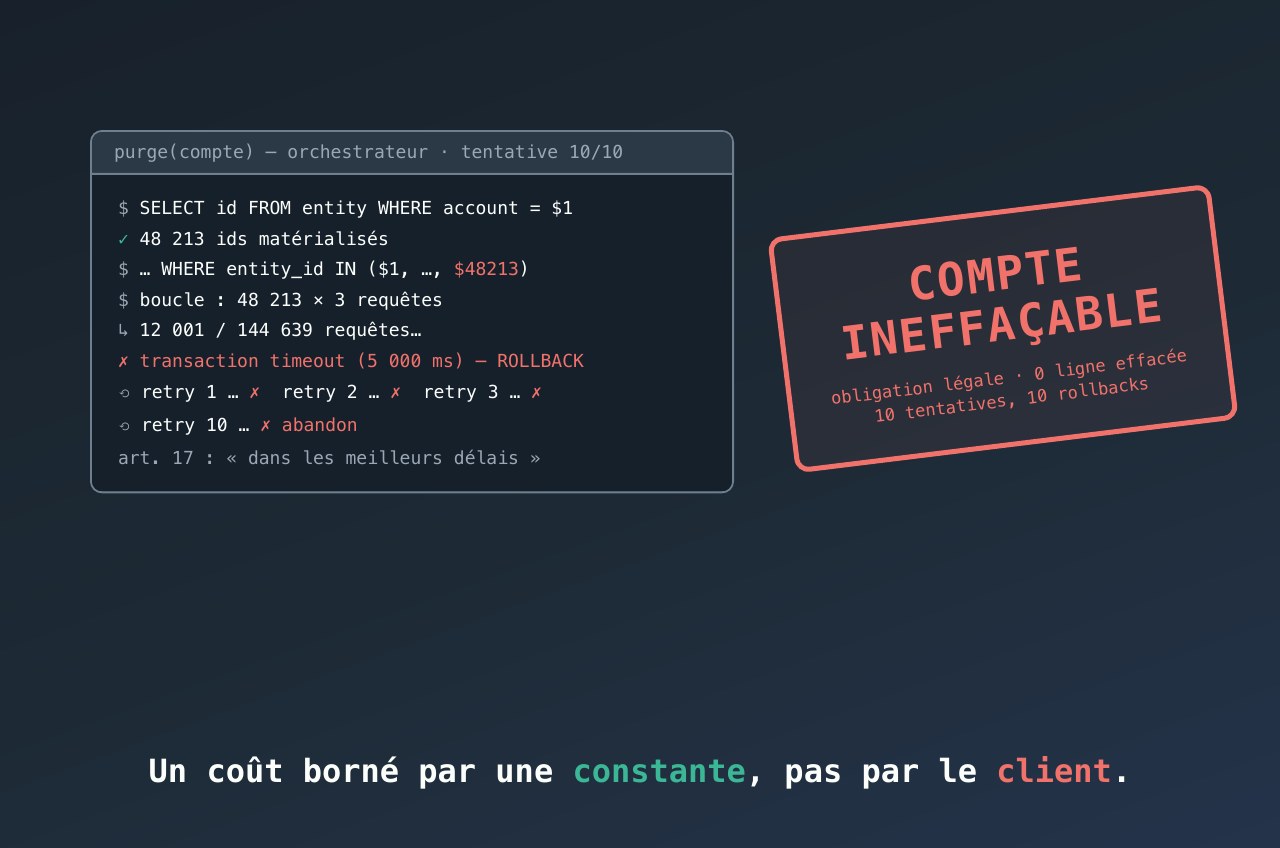
Le jour où ce compte a demandé son effacement, la purge a dépassé le timeout de sa transaction, la transaction a été annulée, et l’orchestrateur de workflows, consciencieux, a rejoué le job. Dix fois. Dix fois le même mur. Un compte devenu ineffaçable, sur une plateforme qui a l’obligation légale de l’effacer. Un comble, me direz-vous ? Je ne vous le fais pas dire.
Ce que je veux vous raconter dans cet article, ce n’est pas « comment j’ai optimisé une requête ». C’est plus intéressant que ça. Cette purge produit une preuve d’effacement : des compteurs, opposables, qui disent combien de lignes ont été anonymisées ici et combien de mandats ont été clos là. La réécrire, c’était donc réécrire un traitement dont la sortie doit rester identique à la ligne près, tout en faisant passer son coût de « proportionnel à la taille du client » à « borné par une constante ». Réécrire sans changer les comptes. C’est cette contrainte-là qui rend l’exercice digne d’un article.
Le décor : effacer, c’est une obligation… et une preuve
Plantons le décor pour ceux qui n’ont jamais eu à implémenter ça.
Le RGPD, dans son article 17, consacre le « droit à l’effacement », que le texte lui-même surnomme le « droit à l’oubli » : la personne concernée a le droit d’obtenir du responsable du traitement l’effacement de ses données « dans les meilleurs délais », et le responsable a l’obligation de le faire, dans les mêmes délais. Pas « quand le batch de nuit voudra bien passer ». Dans les meilleurs délais.
Et il y a un second texte, moins célèbre mais qui change tout pour le développeur : l’article 5, paragraphe 2. Le responsable du traitement doit être « en mesure de démontrer » qu’il respecte les principes du règlement. Autrement dit, il ne suffit pas d’effacer. Il faut pouvoir prouver qu’on l’a fait. Le règlement n’impose pas la forme de cette preuve ; c’est à chacun de la produire.
Alors, concrètement, à quoi ressemble une purge dans un SaaS multi-tenant ? À une transaction qui, pour un compte donné :
- anonymise tout ce qui est identifiant (e-mails, noms, libellés libres), sans supprimer les lignes, parce que d’autres données dépendent d’elles et parce que la comptabilité et les obligations de conservation ont leur mot à dire ;
- clôture tout ce que le compte possédait et qui était encore ouvert (des mandats, des autorisations, appelez ça comme vous voulez selon votre métier) ;
- émet une preuve : un document chiffré qui contient les compteurs de ce qui vient d’être fait, horodaté, conservé à part.
Le point 3 est la clé de toute l’histoire. La preuve n’est pas décorative : elle est ce qu’on sortira le jour où quelqu’un demandera « prouvez-moi que vous avez effacé ». Ses compteurs sont donc opposables. Et un compteur opposable, ça ne se change pas parce qu’on a réécrit le code qui le calcule.
Le jour où la baleine est arrivée
La purge d’origine avait été écrite pour un compte ordinaire. Quelques entités, quelques dizaines de lignes à toucher. Et pour ce cas-là, elle était parfaitement raisonnable :
- elle chargeait la liste des identifiants des entités du compte ;
- elle injectait cette liste dans des clauses
IN (…)pour retrouver ce qui leur appartenait ; - puis, pour chaque entité, elle faisait trois allers-retours SQL : un pour compter, deux pour mettre à jour.
Sur dix entités, ça donne une trentaine de requêtes. Rien de bien sorcier.
Sur des dizaines de milliers d’entités, ça donne un nombre de requêtes à six chiffres. Dans une transaction interactive, c’est-à-dire une transaction que l’ORM garde ouverte pendant que votre code applicatif fait ses allers-retours, et que la plupart des ORM plafonnent à quelques secondes par défaut. Vous voyez le problème arriver : le timeout tombe, la transaction est annulée proprement, aucune ligne n’est touchée. Et comme le job tourne dans un orchestrateur de workflows, celui-ci fait exactement ce pour quoi on l’a configuré : il retente. Encore, et encore, avec le même résultat, jusqu’à épuisement des tentatives.
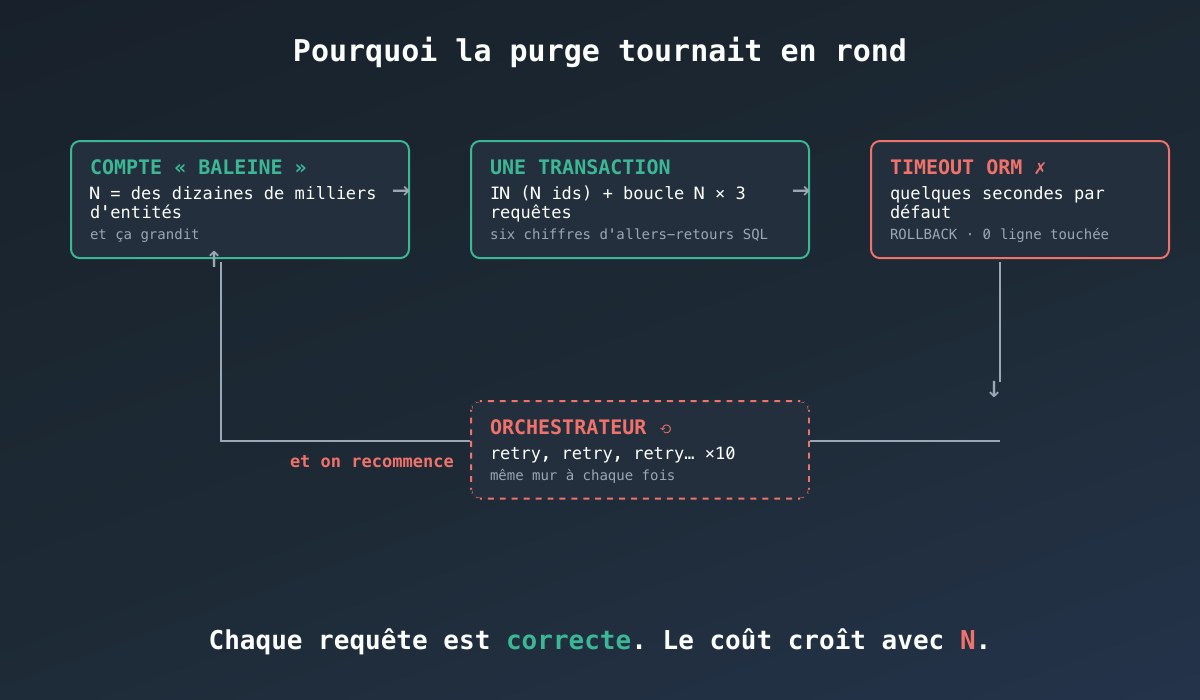
Le plus cruel dans cette histoire ? Rien n’était cassé au sens habituel du terme. Chaque requête était correcte. Chaque test passait, sur des fixtures de dix entités. Le code avait juste une propriété invisible que personne n’avait formulée : son coût croissait avec la taille du client. Et cette propriété-là ne se voit ni à la relecture, ni dans les tests unitaires. Elle se voit le jour où un gros client arrive, c’est-à-dire, par définition, au pire moment.
Le diagnostic : trois anti-patterns qui ne font pas mal à petite échelle
Quand j’ai ouvert le code, je n’ai pas trouvé une erreur. J’en ai trouvé trois, empilées, chacune anodine prise isolément.
Premier anti-pattern : matérialiser des identifiants pour les redistribuer en IN (liste). On charge tous les ids enfants en mémoire, puis on les renvoie à la base dans une clause IN. La taille de la requête elle-même croît avec les données. Certains moteurs ont une limite dure sur le nombre de paramètres liés ; tous ont un coût de parsing qui grimpe. Et surtout, c’est inutile : si le schéma connaît la relation, la base sait déjà quels enfants appartiennent à quel parent.
Deuxième anti-pattern : la boucle applicative « pour chaque entité, trois requêtes ». C’est le plus classique, et le plus insidieux, parce qu’il est lisible. On lit le code, on comprend exactement ce qu’il fait, on hoche la tête. Le nombre d’allers-retours croît linéairement avec le nombre d’entités, et chaque aller-retour paie la latence réseau, le parsing, le plan d’exécution. Cent mille fois quelques millisecondes, ça fait des minutes.
Troisième anti-pattern : hydrater un objet métier complet pour n’en lire qu’un champ. L’ORM charge l’entité entière, avec ses relations, ses dates, ses champs JSON, pour qu’on aille chercher… un booléen. Multipliez par le nombre d’entités, et vous avez un transfert de données massif dont vous n’utilisez que quelques octets.
Ce qui m’a frappé, c’est que ces trois choses sont exactement ce qu’on écrit naturellement avec un ORM quand on pense en objets. « Je récupère mes entités, je boucle, je mets à jour. » C’est le style que l’outil encourage. D’ailleurs, c’est un des reproches que je fais aux ORM depuis longtemps : ils rendent le code correct facile à écrire et le code borné difficile à voir. Bref, le diagnostic était posé. Restait la partie compliquée.
Pourquoi je ne pouvais pas « juste » optimiser
Si cette purge avait été un traitement ordinaire, l’affaire aurait été pliée en une après-midi : on passe en ensembliste, on vérifie que le résultat a l’air bon, on livre.
Sauf que la sortie de ce traitement est une preuve opposable. Si la nouvelle version compte 4 812 lignes anonymisées là où l’ancienne en comptait 4 813, on n’a pas « une petite différence » : on a deux preuves contradictoires pour le même effacement, et aucun moyen de dire laquelle est la bonne. Autant dire que le critère de succès de la réécriture n’était pas « c’est plus rapide ». C’était : à données identiques, compteurs identiques, à la ligne près. Et la vitesse en prime.
Alors, comment on valide ça ? Certainement pas de tête. Je sais, c’est tentant : on relit les deux versions côte à côte, on se convainc que « c’est la même chose écrite autrement », et on passe à autre chose. Mais un raisonnement d’équivalence entre une boucle applicative et une requête ensembliste, ça se trompe facilement. Une condition métier légèrement différente, un NULL traité d’un côté et pas de l’autre, une entité comptée deux fois parce qu’elle apparaît dans deux relations… Chacun de ces détails change un compteur.
Donc j’ai fait ce que je recommande à chaque fois qu’une réécriture doit prouver qu’elle ne change rien : mesurer, pas raisonner. Les deux versions ont tourné sur un environnement réel, sur plusieurs profils de comptes représentatifs (un petit, un moyen, un gros avec des cas tordus), et leurs preuves ont été comparées compteur par compteur. C’est la même discipline que celle que je décrivais à propos du remplacement d’un moteur maison : quand tout marche « à peu près » avant, la seule façon de garantir qu’après marchera exactement, c’est de le constater.
On veut du code !
Passons aux mouvements de la réécriture. Les extraits ci-dessous sont génériques : un schéma inventé, un ORM à la Prisma, pour illustrer chaque principe. Ils ne viennent d’aucun projet réel, mais chaque principe, lui, l’est.
Mouvement 1 : des filtres relationnels au lieu de listes d’identifiants
Voici la version « boucle », celle qui marche très bien sur dix entités :
// AVANT : on matérialise les ids, on les redistribue, on boucle
const entities = await tx.entity.findMany({
  where: { accountId },
  include: { mandates: true, contacts: true }, // hydratation complète
});
const entityIds = entities.map(e => e.id);

const contacts = await tx.contact.findMany({
  where: { entityId: { in: entityIds } }, // taille de la requête ∝ données
});

for (const entity of entities) {
  const open = await tx.mandate.count({ where: { entityId: entity.id, status: "OPEN" } });
  await tx.mandate.updateMany({ where: { entityId: entity.id, status: "OPEN" }, data: { status: "CLOSED" } });
  await tx.contact.updateMany({ where: { entityId: entity.id }, data: { email: "deleted@anonymized.invalid" } });
  counters.mandatesClosed += open;
}
Et voici le premier mouvement : là où le schéma connaît la relation, on filtre par la relation, pas par une liste d’identifiants qu’on a été chercher soi-même.
// APRÈS : un seul paramètre lié, coût indépendant du nombre d'entités
const contacts = await tx.contact.findMany({
  where: { entity: { accountId } }, // la base fait la jointure, pas nous
  select: { id: true },             // et on ne charge que ce qu'on lit
});
Ce petit bout de code permet de remplacer WHERE contact.entity_id IN ($1, $2, …, $40000) par WHERE entity.account_id = $1 avec une jointure. Un seul paramètre. La requête a la même taille que le compte ait dix ou cent mille entités. C’est ça, « borné par une constante » : la taille de ce qu’on envoie à la base ne dépend plus de la taille du client.
Mouvement 2 : des tranches bornées quand la relation n’existe pas
Bien entendu, ce serait trop beau si tout le schéma était propre. Il y avait des tables qui portaient une clé étrangère « nue » : la colonne existe, mais aucune relation n’est déclarée dans le modèle de l’ORM. On ne peut donc pas écrire where: { entity: { accountId } }.
Là, plutôt que de revenir à une liste géante d’ids, on traite par tranches de taille fixe :
const BATCH = 500;
let cursor: string | undefined;

for (;;) {
  const page = await tx.entity.findMany({
    where: { accountId, ...(cursor ? { id: { gt: cursor } } : {}) },
    select: { id: true },
    orderBy: { id: "asc" },
    take: BATCH,
  });
  if (page.length === 0) break;

  const ids = page.map(e => e.id);
  const { count } = await tx.orphanNote.updateMany({
    where: { entityId: { in: ids } },   // 500 ids maximum, jamais plus
    data: { body: "" },
  });
  counters.notesWiped += count;
  cursor = ids[ids.length - 1];
}
Oui, on a encore un IN (…). Mais sa taille est plafonnée à 500, quel que soit le compte. Le coût est borné par tranche, plus jamais par tenant. Le nombre de tranches, lui, croît avec les données, mais chaque tranche est un aller-retour bon marché et prévisible, et c’est précisément ce qu’on veut : un coût linéaire prévisible plutôt qu’une requête unique qui explose.
Mouvement 3 : la clôture ensembliste, et le NOT qui sauve
Les « trois requêtes par entité » (compter, clôturer, anonymiser) deviennent « un COUNT et deux UPDATE par compte ». La base fait le tour des entités, pas nous.
Mais il y a un piège que je veux vous montrer, parce que c’est là que les compteurs divergent le plus souvent. Il arrive qu’une condition métier complexe désigne ce qu’on veut conserver (disons, les mandats dont la fin de vie légale n’est pas atteinte). On a alors besoin de son contraire pour désigner ce qu’on clôture. La tentation est de réécrire la condition « à l’envers ». Ne le faites pas.
// Une seule définition, partagée
const mustBeKept = {
  status: "OPEN",
  legalRetentionUntil: { gt: now },
} as const;

// Ce qu'on clôture = tout ce qui n'est PAS à conserver
const { count: mandatesClosed } = await tx.mandate.updateMany({
  where: { entity: { accountId }, status: "OPEN", NOT: mustBeKept },
  data: { status: "CLOSED", closedAt: now },
});
Nier la définition partagée (NOT: mustBeKept) plutôt que d’en recopier une version inversée, ça garantit une seule source de vérité. Deux copies d’une même règle, dans deux endroits, ça finit toujours par diverger, et avec des compteurs opposables, une divergence n’est pas un détail. C’est une preuve fausse.
Mouvement 4 : le SQL brut est un contrat différent
Voilà un cas que l’ORM ne sait tout simplement pas exprimer. Anonymiser un e-mail en écrivant une valeur dérivée de la ligne elle-même (par exemple deleted-<id>@…, pour garder l’unicité de la colonne sans garder l’information) est impossible en updateMany dans la plupart des ORM : data prend une valeur fixe, pas une expression calculée par ligne.
On passe donc en SQL brut, par tranches, comme au mouvement 2 :
-- Pattern générique : anonymisation dont la valeur dérive de la ligne
UPDATE "users"
SET email        = 'deleted-' || id || '@anonymized.invalid',
    display_name = 'Utilisateur supprimé',
    updated_at   = NOW()          -- l'ORM ne le fera pas pour vous en SQL brut
WHERE id = ANY($1::uuid[]);       -- toute la tranche = UN seul paramètre lié
Deux choses à retenir ici, et elles sont la raison d’être de ce paragraphe.
D’abord, = ANY($1::uuid[]) lie une liste entière comme un seul paramètre. C’est la façon propre, sous PostgreSQL, de passer une tranche d’identifiants sans générer un IN ($1, $2, …, $500) à la taille variable.
Ensuite, et c’est le point que j’ai vu oublier le plus souvent : le SQL brut contourne les automatismes de l’ORM. Le updatedAt que votre modèle met à jour tout seul à chaque update ? En SQL brut, personne ne le touche. Les hooks, les middlewares, le soft delete automatique ? Pareil. Quand vous descendez en SQL, vous signez un autre contrat, et réintroduire explicitement ce que l’ORM faisait pour vous fait partie de la réécriture. Ce n’est pas du polish qu’on fera « plus tard ».
D’ailleurs, c’est ici que mon fil rouge habituel me rend service. Dans une architecture hexagonale, ce SQL vit dans un adaptateur, derrière un port du type « anonymiser ces utilisateurs ». Le cas d’usage de purge, lui, n’a pas bougé d’une ligne : il appelle le même port, reçoit les mêmes compteurs, produit la même preuve. C’est exactement le genre de réécriture où l’on mesure ce que vaut d’avoir isolé le métier de la technique.
Mouvement 5 : les timeouts en poupées russes
Dernier mouvement, et pas le moins important, parce qu’il ne concerne pas la performance mais la sécurité de la preuve.
Une purge, c’est deux temps : la transaction (anonymiser, clôturer, compter), puis, après le commit, l’écriture de la preuve et quelques nettoyages. Le job tourne dans un orchestrateur qui a son propre timeout d’activité, et son propre retry.
Maintenant, imaginez la séquence suivante. La transaction commite. Le job commence à écrire la preuve. Le timeout de l’activité, côté orchestrateur, tombe à cet instant précis. L’orchestrateur tue la tentative et en relance une autre. Cette nouvelle tentative trouve un compte déjà anonymisé : ses compteurs seront à zéro, ou faux, ou elle ne trouvera plus rien à faire. Résultat : un compte effacé, et aucune preuve valide. Le pire des deux mondes : on a fait le travail, et on ne peut plus le démontrer, alors que l’article 5 nous demande justement d’en être capables.
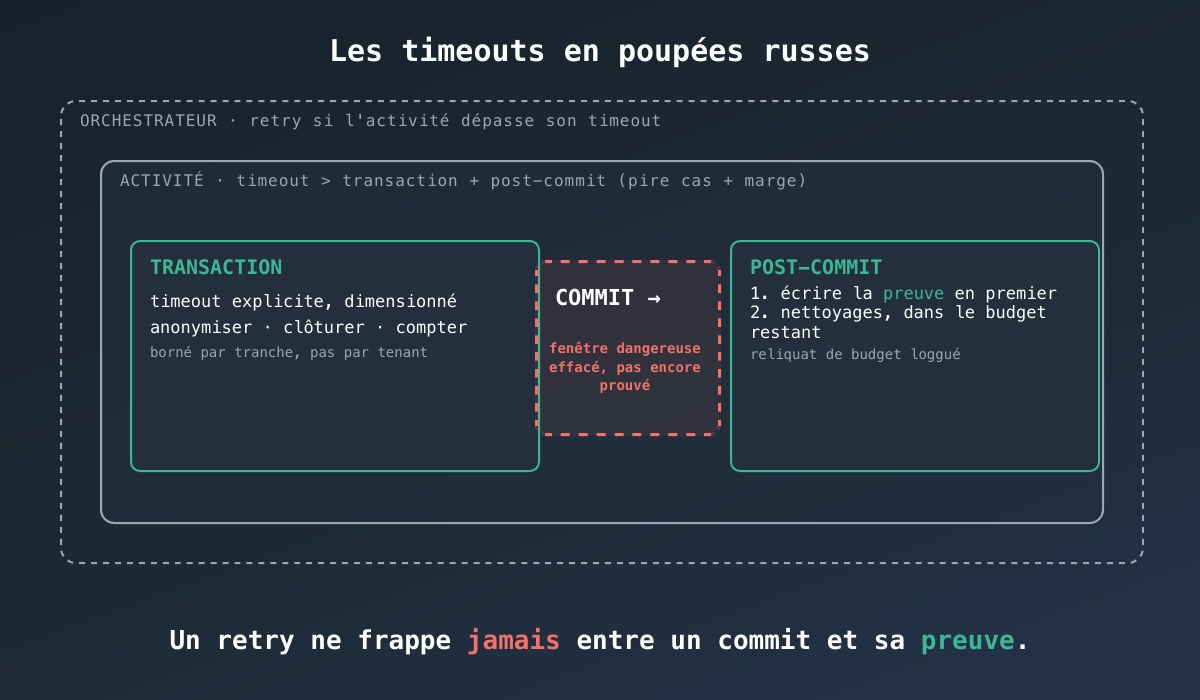
La parade tient en une règle : transaction < activité < orchestrateur, et chaque budget dimensionné au-dessus du pire cas du niveau inférieur.
const TX_TIMEOUT_MS = 60_000;          // pire cas mesuré de la transaction, avec marge
const POST_COMMIT_BUDGET_MS = 30_000;  // preuve + nettoyages
// Côté orchestrateur : timeout d'activité > TX_TIMEOUT_MS + POST_COMMIT_BUDGET_MS

const counters = await prisma.$transaction(
  async tx => runPurge(tx, accountId),
  { timeout: TX_TIMEOUT_MS },
);

const deadline = Date.now() + POST_COMMIT_BUDGET_MS;
await writeProof(accountId, counters);            // en premier : c'est elle qui compte
await runCleanups(accountId, { deadline });       // le reste, dans ce qui reste de budget
logger.info({ accountId, budgetLeftMs: deadline - Date.now() }, "purge post-commit done");
Toute cette petite mécanique fait trois choses. Elle donne à la transaction un timeout dimensionné et explicite, au lieu du défaut de l’ORM. Elle écrit la preuve en premier après le commit, avant tout nettoyage, pour réduire la fenêtre dangereuse au minimum. Et elle logue le reliquat de budget à chaque exécution, pour qu’on voie venir le jour où la marge fond. Le timeout d’activité côté orchestrateur, lui, est relevé au-dessus de la somme des deux, pour qu’un retry ne puisse jamais frapper entre un commit et sa preuve. Ce n’est pas très différent de ce que je racontais dans l’autopsie d’un échec silencieux : ce qui compte, ce n’est pas que chaque couche ait fini, c’est que la preuve existe.
La prise accessoire : un job qui échouait depuis des semaines
Quand on re-teste un traitement sur des données réelles, on trouve ce qu’on cherchait, et parfois autre chose.
En faisant tourner la nouvelle version, un job périodique voisin s’est mis à me crier dessus. Il filtrait sur une relation que sa table n’avait jamais eue. L’ORM rejetait la clause à l’exécution, à chaque tick, depuis des semaines. Aucune alerte, parce que l’erreur était avalée quelque part. Aucun test ne couvrait cette clause. Et le build incrémental ne re-vérifiait plus ce fichier depuis longtemps, si bien que même la compilation ne se plaignait pas.
La leçon dans la leçon, je l’ai déjà écrite sous une autre forme dans ce que les tests ne voient pas : un test d’intégration qui exécute réellement la requête attrape ce que ni la compilation, ni un test unitaire avec un dépôt mocké ne verront jamais. Un where invalide est une chaîne parfaitement typée jusqu’au moment où la base le lit.
Ce que j’en retiens
Le coût d’un traitement doit être borné par une constante, pas par la taille du client. Chaque IN (liste matérialisée), chaque boucle « pour chaque entité », chaque hydratation complète pour lire un champ, est une dette qui n’apparaît sur aucune facture jusqu’au premier gros client. Quand vous relisez du code, posez-vous la question qui n’est jamais dans la checklist : « et si ce compte avait cent mille fois plus de lignes ? »
Une réécriture sous preuve d’équivalence se valide par mesure, pas par raisonnement. Quand la sortie est opposable (des compteurs, une preuve légale, un export comptable), les deux versions tournent côte à côte sur des données réelles et on compare, à la ligne près, avant de remplacer. Le raisonnement « c’est la même chose écrite autrement » est exactement celui qui se trompe sur les NULL et les doublons.
Le SQL brut est un contrat différent. Les automatismes de l’ORM ne s’appliquent plus : horodatage, hooks, soft delete. Les réintroduire explicitement fait partie de la réécriture. Et si votre architecture isole ce SQL dans un adaptateur, le métier n’a même pas besoin de savoir que vous avez changé de contrat.
Alignez vos timeouts en poupées russes. Transaction < activité < orchestrateur, chaque niveau dimensionné au-dessus du pire cas du précédent. Le retry d’un système extérieur ne doit jamais pouvoir frapper entre un commit et l’écriture de sa preuve. Une purge commitée sans preuve, c’est un travail fait qu’on ne peut plus démontrer.
Épilogue
Récapitulons. Un compte devenu ineffaçable parce qu’une purge honnête, testée, relue, avait une propriété que personne n’avait nommée : son coût grandissait avec le client. Trois anti-patterns empilés, tous naturels avec un ORM. Une contrainte qui interdisait de « juste optimiser » : des compteurs opposables à reproduire à l’identique. Et cinq mouvements pour s’en sortir : filtrer par la relation, trancher quand elle manque, clôturer en ensembliste en niant la règle plutôt qu’en la recopiant, descendre en SQL brut en assumant le nouveau contrat, et emboîter les timeouts pour que la preuve soit inatteignable par un retry.
Rien de bien sorcier, pris un par un. Ce qui est sorcier, c’est de le faire sans changer un seul compteur, et de pouvoir le prouver.
Et vous, avez-vous déjà eu un traitement « qui marchait » jusqu’à l’arrivée d’un gros client ? Une purge, un export, une facturation de fin de mois qui ne passait plus ? Racontez-moi ça en commentaire, je me ferai une joie de vous répondre. Et si le sujet des limites partagées en base vous intéresse, j’en parlais aussi dans un compteur ne fait pas un quota, qui est un peu le cousin de cet article.