Table des matières
Ouvrir table des matières
Un ping reçu, puis plus jamais rien
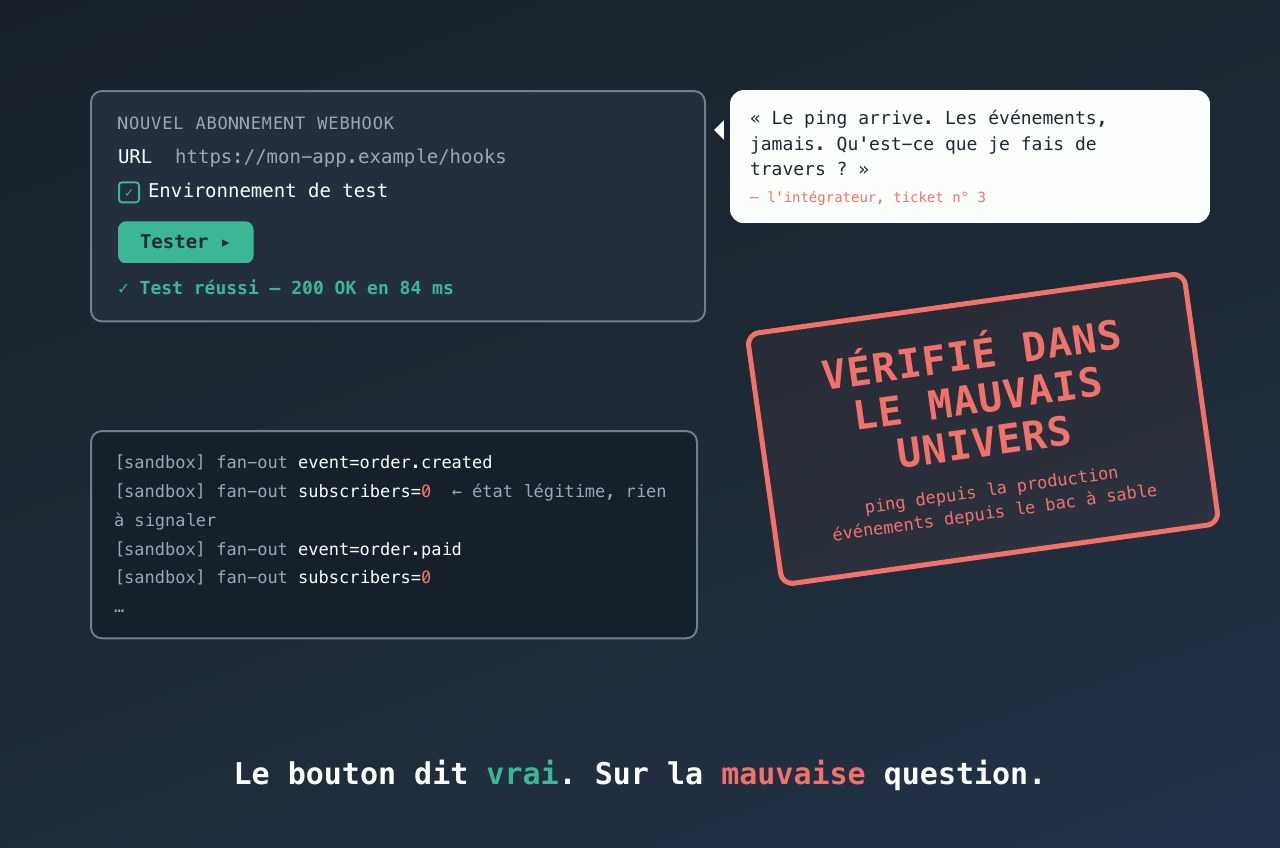
Mettez-vous à la place d’un intégrateur. Vous branchez votre application sur un SaaS. Vous créez un abonnement webhook depuis l’interface, vous cochez la case « environnement de test » parce que vous êtes quelqu’un de sérieux, et vous cliquez sur le bouton « Tester ». Votre endpoint reçoit le ping. Statut 200. Tout est vert.
Et puis plus rien. Jamais. Pas un seul événement métier. Vous déclenchez des actions dans le bac à sable, vous attendez, vous vérifiez vos logs, vous relancez le test : le ping arrive toujours, les événements jamais. Vous finissez par ouvrir un ticket, un peu agacé, en joignant la preuve que « ça marche » et la preuve que « ça ne marche pas ».
De mon côté du ticket, il m’a fallu un moment pour comprendre que le bouton n’avait pas menti sur ce qu’il vérifiait. Il avait menti sur le monde depuis lequel il parlait. Et c’est ce piège-là, classique dès qu’on sépare physiquement un environnement de test, que je veux démonter avec vous. Avec, en prime, les trois aggravants qui l’ont rendu invisible pendant bien trop longtemps, et les trois règles de conception qui l’ont réparé pour de bon.
Le décor : un SaaS, des webhooks, et deux univers qui ne se parlent pas
Plantons le décor. Un SaaS B2B propose des webhooks sortants : quand quelque chose se passe côté plateforme, elle appelle une URL que l’intégrateur a déclarée. Rien d’exotique, j’en avais déjà expliqué la mécanique dans produire des webhooks sur son API.
Les abonnements se créent depuis l’interface web. Cette interface, comme toute interface, parle à l’API de production et écrit dans la base de production. Jusque-là, rien à redire.
Maintenant, le bac à sable. Pour de bonnes raisons d’isolation (des données de test qui ne doivent jamais contaminer la production, des tiers externes appelés en mode « faux », des comportements qu’on veut pouvoir casser sans conséquence), l’environnement de test n’est pas un simple drapeau isTest dans la base de production. C’est un déploiement séparé, avec sa propre base de données, ses propres workers, sa propre file. Deux univers parallèles.
Bien entendu, ces deux univers doivent quand même partager certaines choses : les comptes clients, les clés d’API, un peu de configuration. Un pont de synchronisation existait donc déjà : la production envoie périodiquement un instantané au bac à sable, qui le réplique chez lui. Ce pont marchait très bien.
Il ne faisait juste pas voyager les abonnements webhook. Personne n’y avait pensé. Et c’est là que tout se joue.
Le mensonge structurel
Reprenons la séquence du ticket, mais vue depuis l’architecture.
L’intégrateur crée son abonnement avec la case « test » cochée. L’API de production écrit la ligne dans sa base. Il clique sur « Tester ». L’API de production, celle qui vient d’écrire la ligne, envoie un ping synchrone à l’endpoint déclaré. L’endpoint répond 200. L’interface affiche « test réussi ».
Ce ping prouve une chose, et une seule : l’endpoint est joignable et répond. C’est un test de connectivité. Il ne prouve rigoureusement rien sur ce qui va se passer ensuite.
Parce que, ensuite, les vrais événements de test sont émis par l’univers sandbox. Et le fan-out des événements, dans cet univers, fait ce que fait tout fan-out : il lit la table des abonnements de sa base pour savoir à qui envoyer. Or dans sa base, l’abonnement n’existe pas. Il a été écrit de l’autre côté. Le fan-out trouve zéro abonné.
Et voilà le point vraiment vicieux : zéro abonné est un état parfaitement légitime. La plupart des comptes n’ont aucun webhook. Le fan-out ne loggue donc rien d’anormal, ne lève aucune alerte, ne laisse aucune trace. Du point de vue du système, tout va bien. Du point de vue de l’intégrateur, le silence est total.
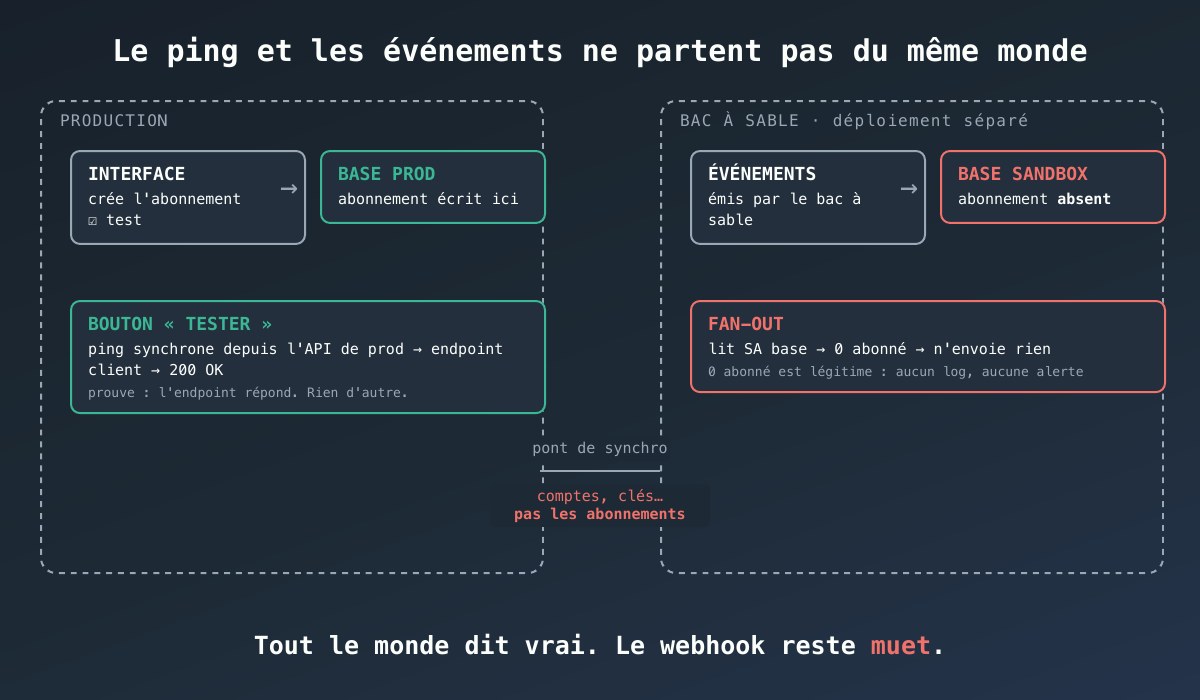
Si vous avez lu mon autopsie d’un échec silencieux, vous reconnaîtrez la famille : chaque composant dit vrai, l’ensemble ment. Le bouton « Tester » ne mentait pas. Il répondait honnêtement à une question que personne n’avait posée.
Les trois aggravants
Un bug d’architecture comme celui-là, on devrait le trouver en une heure. Il a fallu beaucoup plus, à cause de trois détails qui, chacun de leur côté, avaient l’air anodins.
Premier aggravant : un champ absent mappé vers false. Le contrat serveur-à-serveur qui crée un abonnement portait un booléen « environnement de test ». Quand un appelant omettait ce champ, le serveur le lisait comme false. Ça paraît raisonnable, c’est même le réflexe par défaut. Sauf que false, c’est précisément la seule valeur qui ne peut jamais matcher côté sandbox. Tout appelant qui oubliait le champ créait donc, sans le savoir, un abonnement de production. Un défaut « de bon sens » qui condamnait silencieusement une catégorie entière d’appelants.
Deuxième aggravant : l’écran de diagnostic était lui-même en panne. L’interface proposait un historique des envois, exactement l’outil qu’il faut pour comprendre pourquoi un webhook ne part pas. Sauf que cet écran envoyait des filtres de date au format « jour seul » (2026-08-25) à une API qui exigeait un date-time complet. Résultat : une erreur 400 à chaque ouverture. L’outil censé rendre le bug visible était cassé au moment précis où on en avait besoin. Un comble pour un écran de diagnostic, me direz-vous.
Troisième aggravant : un identifiant malformé qui remontait en 500. Un identifiant mal formé dans l’URL descendait jusqu’à la colonne UUID de la base, qui le rejetait, et l’erreur remontait en erreur interne non attrapée. Au lieu d’un 400 propre qui dit « votre identifiant est invalide », un 500 qui dit « quelque chose a explosé quelque part ». Sur un ticket où on cherche déjà une aiguille, chaque 500 parasite est une fausse piste.
Trois détails. Aucun n’était la cause. Tous ont rallongé le diagnostic.
Pourquoi pas une autre approche ?
Avant de vous montrer ce que j’ai fait, un mot sur ce que je n’ai pas fait, parce que le raisonnement compte autant que la solution.
Fusionner les deux bases. La tentation existe : un seul déploiement, un drapeau isTest sur les lignes, et plus de problème de synchronisation. Sauf que l’isolation physique du bac à sable n’était pas un caprice. Elle protège la production des données de test, des tiers en mode « faux », des comportements qu’on veut pouvoir casser. Renoncer à ça pour corriger un bug de routage, c’est soigner un rhume avec une amputation.
Envoyer le ping depuis le bac à sable. Bonne idée, et je l’ai gardée en complément : si le bouton « Tester » d’un abonnement de test faisait transiter le ping par l’univers sandbox, il prouverait au moins que cet univers connaît l’abonnement. Mais ça ne règle pas la cause : l’abonnement n’y serait toujours pas. Ça transformerait juste un faux succès en vrai échec, ce qui est déjà mieux, mais pas suffisant.
Demander à l’intégrateur de créer ses abonnements deux fois. Une interface pour la production, une pour le bac à sable. C’est ce que font certaines plateformes, et je trouve ça pénible côté intégrateur. Le pont de synchronisation existait déjà pour les comptes et les clés ; la solution propre était de lui faire porter une entité de plus.
On veut du code !
Les extraits qui suivent sont génériques : un instantané JSON, un contrat validé par un schéma, un dépôt abstrait. Aucun nom de table réel. Mais les trois règles de conception, elles, sont exactement celles qui tournent.
Règle 1 : une provenance explicite
Faire voyager les abonnements dans le pont, c’est facile à dire. Le piège, c’est la réconciliation : quand un abonnement disparaît côté production, il doit disparaître côté sandbox. Donc le récepteur supprime ce qui n’est plus dans l’instantané. Et là, catastrophe potentielle : le bac à sable a aussi ses propres abonnements, créés nativement chez lui, qui n’ont jamais existé côté production. Une réconciliation naïve les effacerait à chaque passage.
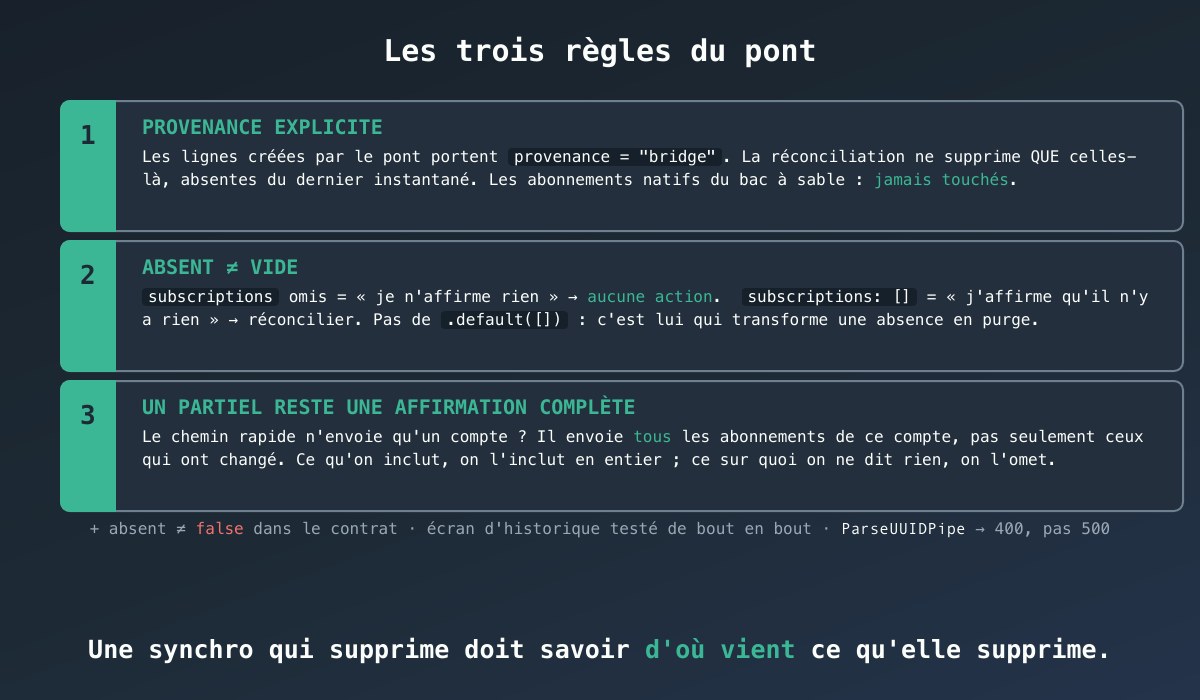
D’où la première règle : les lignes créées par le pont sont marquées comme telles, et la réconciliation ne touche que celles-là.
// Pattern générique : upsert avec provenance, réconciliation bornée à cette provenance
const BRIDGE = "bridge" as const;

async function applySubscriptionsSnapshot(
  accountId: string,
  incoming: SubscriptionSnapshot[],
  repo: SubscriptionRepositoryPort
): Promise<void> {
  for (const sub of incoming) {
    await repo.upsert({ ...sub, accountId, provenance: BRIDGE });
  }

  const incomingIds = new Set(incoming.map(s => s.id));
  const bridged = await repo.findByProvenance(accountId, BRIDGE);
  const stale = bridged.filter(s => !incomingIds.has(s.id));

  // On ne supprime QUE ce que le pont a lui-même créé et qui a disparu de la source.
  // Les abonnements natifs du bac à sable n'ont pas cette provenance : jamais touchés.
  await repo.deleteMany(stale.map(s => s.id));
}
Ce petit bout de code permet de rendre la réconciliation inoffensive pour tout ce qu’elle n’a pas créé. Une synchronisation qui supprime doit toujours savoir d’où vient ce qu’elle supprime. Sans ce marqueur, elle finit fatalement par effacer des données qui appartiennent à quelqu’un d’autre, et ce jour-là, on ne comprend pas tout de suite pourquoi.
Règle 2 : absent n’est pas vide
Deuxième piège, plus subtil. L’instantané est un document JSON envoyé par la production. Le jour du déploiement, il y a forcément un moment où l’émetteur (la production) et le récepteur (le bac à sable) ne sont pas à la même version. Si le bac à sable, tout neuf, reçoit un instantané émis par une production pas encore déployée, le champ subscriptions n’y figure pas.
Que doit-il en conclure ? Certainement pas « il n’y a aucun abonnement, réconcilions ». Ce serait une purge déclenchée par une simple différence de version. La règle : un champ omis signifie « je n’affirme rien », et un tableau vide signifie « j’affirme qu’il n’y a rien ». Ce sont deux messages différents, et le schéma doit les distinguer.
import { z } from "zod";

const SnapshotSchema = z.object({
  account: AccountSchema,
  apiKeys: z.array(ApiKeySchema),
  // Optionnel, SANS valeur par défaut : absent ≠ [].
  subscriptions: z.array(SubscriptionSchema).optional(),
});

async function applySnapshot(raw: unknown, deps: Deps): Promise<void> {
  const snap = SnapshotSchema.parse(raw);
  await applyAccount(snap.account, deps);
  await applyApiKeys(snap.apiKeys, deps);

  if (snap.subscriptions === undefined) {
    // L'émetteur ne parle pas des abonnements : on ne touche à rien.
    return;
  }
  // Tableau présent (même vide) : c'est une affirmation, on réconcilie.
  await applySubscriptionsSnapshot(
    snap.account.id,
    snap.subscriptions,
    deps.subscriptions
  );
}
Remarquez ce qu’il n’y a pas dans ce schéma : un .default([]). C’est la ligne qu’on écrit par réflexe, et c’est exactement celle qui transforme une absence en affirmation. Le même réflexe que le absent → false du premier aggravant, d’ailleurs. Dans les deux cas, on a choisi une valeur par défaut « raisonnable » sans se demander ce que cette valeur déclenche en aval.
Règle 3 : un instantané partiel reste une affirmation complète
Troisième règle, celle qui m’a demandé le plus de réflexion. Le pont avait un « chemin rapide » : quand une seule entité changeait côté production, plutôt que de renvoyer l’instantané complet du compte, il n’envoyait que le sous-ensemble concerné. Économe, malin.
Sauf que le récepteur, lui, traite tout ce qu’il reçoit comme la vérité. S’il reçoit un tableau d’abonnements, il réconcilie dessus. Donc si le chemin rapide envoie « les abonnements liés à l’entité qui vient de changer » et rien d’autre, le récepteur va supprimer tous les autres, qu’il croit disparus.
La règle : tout ce que le récepteur va traiter comme une affirmation complète doit l’être. Si l’émetteur veut n’envoyer qu’une partie, c’est à lui d’aller chercher les entités liées manquantes pour compléter, plutôt que de les filtrer et de laisser le récepteur deviner.
// Côté émetteur (production) : le chemin rapide complète avant d'envoyer
async function buildFastPathSnapshot(
  accountId: string,
  changedIds: string[],
  deps: Deps
) {
  const account = await deps.accounts.get(accountId);
  // Même si un seul abonnement a changé, on envoie TOUS ceux du compte :
  // le récepteur réconcilie sur ce tableau, il doit être complet.
  const subscriptions = await deps.subscriptions.findAllForAccount(accountId);
  return { account, apiKeys: undefined, subscriptions };
  // apiKeys omis : « je n'affirme rien sur les clés » (règle 2), pas « il n'y en a pas ».
}
Vous voyez comment les règles 2 et 3 se répondent : on omet ce sur quoi on ne veut rien dire, et ce qu’on inclut, on l’inclut en entier. Il n’y a pas d’entre-deux, et c’est justement l’entre-deux qui casse.
Et les trois aggravants ?
Ils ont eu droit chacun à leur correctif, plus modeste mais pas moins utile.
Le champ absent ne vaut plus false. Il est désormais requis dans le contrat serveur-à-serveur : un appelant qui l’omet reçoit un 400 explicite, au lieu de créer silencieusement un abonnement dans le mauvais univers. Un défaut qui exclut du routage n’a pas le droit d’être implicite.
L’écran d’historique envoie enfin le bon format de date. Et surtout, il a maintenant un test qui l’ouvre vraiment, avec un filtre, contre le vrai schéma de l’API. C’est la même leçon que dans 600 tests verts pour une application jamais lancée : un outil de diagnostic qu’aucun test n’exerce de bout en bout est un outil dont vous découvrirez la panne le jour où vous en aurez besoin.
L’identifiant malformé est rejeté à l’entrée. En NestJS, c’est littéralement un ParseUUIDPipe sur le paramètre de route : un 400 propre avant que quoi que ce soit ne descende jusqu’à la base.
@Get(":id")
findOne(@Param("id", new ParseUUIDPipe()) id: string) {
  return this.subscriptions.findOne(id);
}
Rien de bien sorcier. Mais un 400 qui dit « votre identifiant est invalide » évite une fausse piste à celui qui cherche déjà une aiguille.
Ce que j’en retiens
Un test de connectivité ne teste que la connectivité. Si le chemin nominal traverse un autre univers (autre déploiement, autre base, autre file), le bouton « Tester » doit emprunter ce chemin-là, ou dire explicitement ce qu’il ne prouve pas. Un test qui réussit sur un chemin que la production n’emprunte pas est pire qu’aucun test : il rassure.
Ne mappez jamais un champ absent vers une valeur discriminante. absent → false, absent → [], c’est un choix de design, pas une évidence. Quand la valeur par défaut exclut silencieusement du routage ou déclenche une purge, ce défaut est une bombe à retardement. Absent veut dire « je n’affirme rien », et c’est tout.
Une synchronisation qui supprime doit connaître la provenance de ce qu’elle supprime. Réconcilier sans marqueur d’origine finit toujours par effacer des données créées par quelqu’un d’autre. Le marqueur coûte une colonne. L’oubli coûte un incident.
L’écran de diagnostic fait partie du chemin critique. Quand l’historique des envois est lui-même cassé, un bug de routage devient invisible. Testez vos outils d’observation comme des fonctionnalités, parce que c’en sont.
Épilogue
Récapitulons. Un intégrateur qui fait tout bien, un bouton « Tester » qui répond vrai à une question qu’on ne lui posait pas, un fan-out qui trouve zéro abonné et n’a aucune raison de s’en inquiéter. Un pont de synchronisation qui existait déjà et à qui il manquait une entité. Trois règles pour la lui confier sans casser le reste : une provenance explicite, absent qui n’est pas vide, et un partiel qui reste une affirmation complète. Et trois petits aggravants, corrigés au passage, qui avaient transformé un bug d’une heure en enquête.
D’ailleurs, c’est ici que mon fil rouge sur l’architecture hexagonale me rassure un peu : le port SubscriptionRepositoryPort et le schéma d’instantané sont les deux seuls endroits où ces règles vivent. Le jour où le pont changera de transport, elles ne bougeront pas.
Et vous, avez-vous un environnement de test physiquement séparé ? Qu’est-ce qui, chez vous, est vérifié dans un univers et exécuté dans un autre ? Un bouton « Tester », un « envoyer un e-mail de test », un « valider la configuration » qui ne passe pas par le vrai chemin ? Racontez-moi ça en commentaire, je me ferai une joie de vous répondre.