Table des matières
Ouvrir table des matières
- Combien de temps a-t-on le droit de croire un diagnostic ?
- Le décor : une passkey, un seul téléphone, et un lockout qui attend son heure
- Le cache naïf, et pourquoi il a sauté en revue
- L’asymétrie des coûts d’erreur
- La solution : deux durées de vie, et l’alerte qui ne clignote pas
- On veut du code !
- Pourquoi pas une autre approche ?
- Ce que j’en retiens
- Épilogue
Combien de temps a-t-on le droit de croire un diagnostic ?
Voilà une question que je ne m’étais jamais posée sous cette forme avant cette histoire. On met des choses en cache tous les jours : une réponse d’API, un profil utilisateur, un calcul un peu lourd. Et à chaque fois, on choisit une durée de vie, un TTL, un peu au doigt mouillé. Cinq minutes, une heure, un jour. Une constante, écrite en haut du fichier, et on passe à autre chose.
Sauf que cette fois, la chose mise en cache n’était pas une donnée. C’était un verdict. Un diagnostic de sécurité, affiché à l’utilisateur sous forme de bannière : « attention, votre compte est fragile ». Et un verdict, ça n’a pas la même valeur selon ce qu’il dit. Croire trop longtemps un « tout va bien » et croire trop longtemps un « vous êtes en danger », ce ne sont pas deux erreurs symétriques. L’une coûte quelques jours de retard. L’autre coûte la crédibilité de toutes vos alertes.
Cet article raconte comment je suis passé d’un cache naïf à sept jours, repéré en revue de code comme une mauvaise idée, à un cache asymétrique : le verdict rassurant vit sept jours, le verdict alarmant expire en vingt-quatre heures. Avec, au passage, deux garde-fous qui valent à eux seuls le détour : on n’affirme que ce que le serveur a prouvé, et on ne cache jamais une absence de réponse.
Le décor : une passkey, un seul téléphone, et un lockout qui attend son heure
Plantons le décor pour ceux qui ne vivent pas dans l’authentification au quotidien.
Les passkeys, ce sont ces identifiants sans mot de passe qui reposent sur une paire de clés : la clé privée reste dans un authentificateur, et le site vérifie une signature. C’est très bien. Mais toutes les passkeys ne se ressemblent pas. Certaines sont synchronisées entre vos appareils par un trousseau. D’autres sont liées à un appareil précis, sans copie ailleurs. Et là, imaginez le scénario : votre seul second facteur confirmé est une passkey liée à votre téléphone. Vous perdez le téléphone. Vous êtes dehors. Pas de « mot de passe oublié » qui tienne, puisque le facteur, c’était l’appareil.
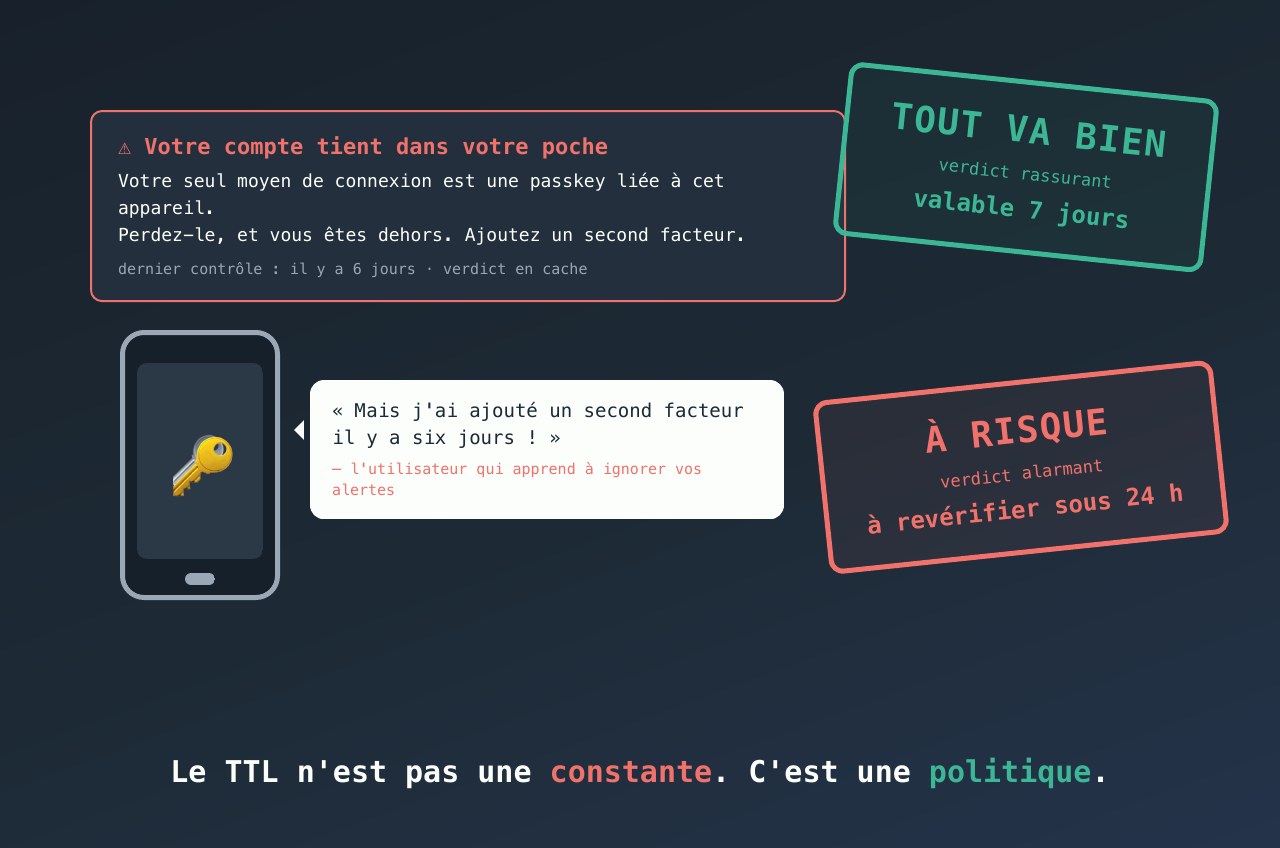
Une application qui tient à ses utilisateurs a donc envie de les prévenir avant que ça n’arrive. Une petite bannière, pas agressive, qui dit en substance : « vous n’avez qu’un seul moyen de rentrer, et il tient dans votre poche ; ajoutez-en un autre ». C’est ce qu’on appelle un nudge. Un coup de coude.
Rien de bien sorcier sur le papier. Sauf que pour savoir si un utilisateur est dans cette situation, il faut poser la question au fournisseur d’identité, via son API de gestion. Et cette question-là est chère : plusieurs allers-retours, pas de cache côté fournisseur, un quota d’appels qu’on partage avec tout le reste. Impossible de la poser à chaque chargement de page. Il faut plafonner : au plus une fois par démarrage de l’application, au plus une fois par fenêtre de N jours par utilisateur.
Et c’est là que le piège se referme. L’utilisateur qui corrige sa situation, qui ajoute un second facteur, le fait sur une page d’enrôlement hébergée chez le fournisseur. Mon application ne reçoit aucun signal de retour. Aucun webhook, aucun événement « il vient d’ajouter un facteur ». Je ne peux pas savoir qu’il est sorti de l’état à risque. Je ne peux que re-demander.
Le cache naïf, et pourquoi il a sauté en revue
Première version, celle que n’importe qui écrirait un mardi après-midi : un tampon « dernier contrôle effectué », valable sept jours, quel que soit le résultat. Le code était propre, testé, et il faisait exactement ce qu’on lui demandait : diviser par beaucoup le nombre d’appels au fournisseur.
Et puis la revue est passée par là. La remarque tenait en une phrase : « et l’utilisateur à risque qui corrige le jour même, il voit la bannière pendant encore six jours ? »
Eh oui. Il la voit. Une bannière qui lui dit « votre compte est fragile », alors qu’il vient précisément de le renforcer. Et pas une bannière anodine : une alerte de sécurité. Le genre de message qu’on voudrait que les gens prennent au sérieux. Que se passe-t-il quand quelqu’un voit une alerte de sécurité manifestement fausse pendant six jours ? Il apprend. Il apprend que vos alertes ne veulent rien dire. Et la prochaine, celle qui sera vraie, il la fermera d’un clic sans la lire.
Pendant ce temps, l’autre cas, l’utilisateur sain qu’on re-contrôlerait trop souvent, ne coûte… que des appels d’API. De l’argent, un peu de quota. Rien qui n’abîme la confiance.
C’est là que ça a fait tilt. Les deux erreurs de cache n’avaient pas le même prix, et je leur avais donné la même durée de vie.
L’asymétrie des coûts d’erreur
Posons-le proprement, parce que c’est le cœur de l’article et que ça dépasse largement mon cas de passkeys.
Un cache, c’est une croyance qu’on accepte de garder périmée pendant un moment. La bonne question n’est donc pas « combien de temps la donnée reste valable ? », mais « combien me coûte d’y croire alors qu’elle ne l’est plus ? ». Et quand la donnée est un verdict binaire, il faut poser la question deux fois.
- Croire trop longtemps un verdict négatif (« pas à risque ») alors que l’utilisateur est devenu à risque. Concrètement, il a retiré un facteur, ou en a perdu un. Le coût : quelques jours de retard sur un avertissement. Le risque ne s’est pas matérialisé, on l’aurait prévenu un peu tard. Acceptable.
- Croire trop longtemps un verdict positif (« à risque ») alors que l’utilisateur a corrigé. Le coût : une alerte de sécurité mensongère, affichée pendant des jours, chez quelqu’un qui a fait exactement ce qu’on lui demandait. L’utilisateur apprend à ignorer vos alertes. Inacceptable.
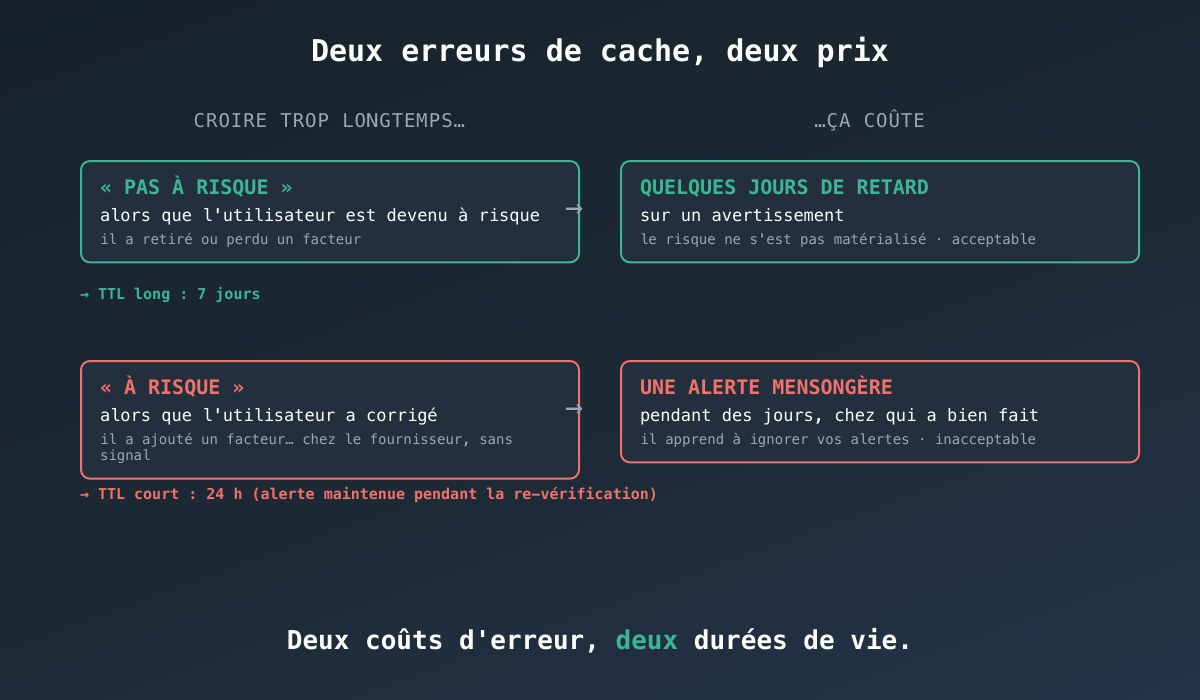
Autant dire que la constante unique en haut du fichier était une erreur de modélisation, pas un mauvais réglage. On ne cherchait pas la bonne valeur de TTL. On cherchait à admettre qu’il en fallait deux.
La solution : deux durées de vie, et l’alerte qui ne clignote pas
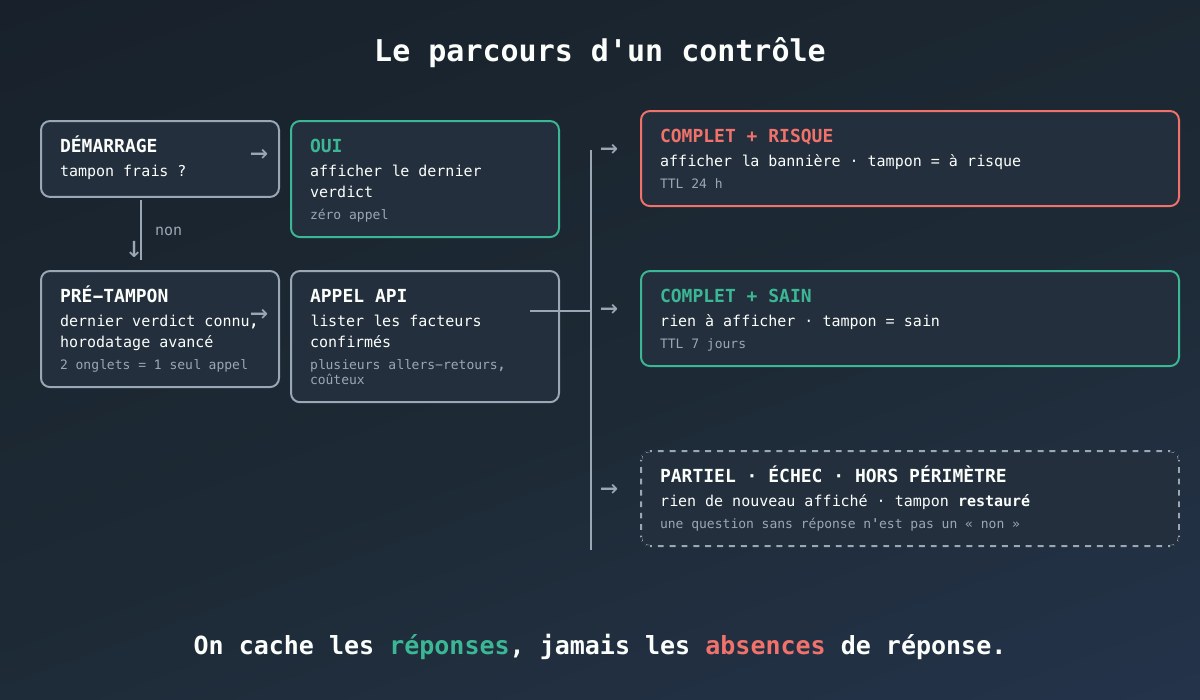
La règle tient en deux lignes. Un verdict négatif repose la fenêtre complète : sept jours avant de re-demander. Un verdict positif se re-vérifie après vingt-quatre heures. Le verdict pénalisant, celui qui accuse, est celui qui a le moins le droit de vieillir.
Et un détail d’expérience utilisateur qui n’en est pas un : pendant la re-vérification, on garde l’avertissement affiché. Le verdict précédent disait « à risque », l’appel de contrôle est en cours, on ne sait pas encore. On ne fait pas disparaître une alerte de sécurité le temps d’une requête réseau pour la faire réapparaître deux cents millisecondes plus tard. Une alerte qui clignote au rythme des requêtes, c’est une alerte que personne ne prend au sérieux. Le dernier état connu reste à l’écran jusqu’à ce qu’un verdict frais le remplace.
On veut du code !
Les extraits ci-dessous sont génériques : un tampon en stockage local, un service de diagnostic abstrait, aucun nom de champ réel. Le principe, lui, est exactement celui qui tourne.
Le tampon et sa fraîcheur
// Pattern générique : deux durées de vie pour un même verdict
const TTL_SAFE_MS = 7 * 24 * 3600 * 1000;    // verdict rassurant : longue vie
const TTL_AT_RISK_MS = 24 * 3600 * 1000;     // verdict alarmant : décote rapide

type VerdictStamp = {
  at: number;       // horodatage du dernier contrôle
  atRisk: boolean;  // dernier verdict connu
};

function isVerdictFresh(stamp: VerdictStamp): boolean {
  const ttl = stamp.atRisk ? TTL_AT_RISK_MS : TTL_SAFE_MS;
  return Date.now() - stamp.at < ttl;
}
Ce petit bout de code permet de faire toute la différence : la durée de vie n’est plus une propriété du cache, c’est une propriété du verdict. Le même tampon vit une semaine ou un jour selon ce qu’il contient. C’est bête comme chou une fois écrit, et c’est précisément le genre de bêtise qu’on n’écrit pas tant qu’on n’a pas nommé l’asymétrie.
Le diagnostic : n’affirmer que ce qui est prouvé
C’est ici que vit le premier garde-fou, et il mérite qu’on s’y arrête. Quand on interroge l’API du fournisseur pour lister les facteurs d’un utilisateur, la réponse peut être complète ou partielle. Pagination, quota, une erreur sur un des appels de la série : autant de façons d’obtenir une liste tronquée. Et une liste tronquée ne prouve rien. Si je ne vois qu’un seul facteur parce que je n’ai pas réussi à charger les autres, je ne peux pas en conclure que l’utilisateur n’en a qu’un.
Donc le diagnostic ne renvoie pas un booléen. Il renvoie un verdict à trois états :
type Diagnosis =
  | { kind: "at-risk" }        // liste complète, et elle montre le risque
  | { kind: "safe" }           // liste complète, pas de risque
  | { kind: "inconclusive" };  // liste partielle, échec, ou cas hors périmètre

async function diagnose(userId: string, idp: IdentityProviderPort): Promise<Diagnosis> {
  const factors = await idp.listConfirmedFactors(userId);
  if (!factors.complete) return { kind: "inconclusive" };

  // Aucun facteur du tout : ce n'est pas « à risque au sens de cette bannière »,
  // c'est un autre problème, traité ailleurs.
  if (factors.items.length === 0) return { kind: "inconclusive" };

  const onlyOne = factors.items.length === 1;
  const deviceBound = factors.items[0]?.type === "passkey" && factors.items[0].deviceBound;
  return onlyOne && deviceBound ? { kind: "at-risk" } : { kind: "safe" };
}
Deux choses à noter. D’abord le cas « aucun facteur » : on pourrait être tenté de le ranger dans « à risque », après tout il n’a même pas de second facteur. Mais ce n’est pas le message de cette bannière, qui parle d’une passkey liée à un appareil. Un utilisateur sans aucun facteur relève d’un autre parcours, d’une autre surface. Mélanger les deux, c’est afficher un message qui ne correspond pas à la situation, et on revient au problème de l’alerte qu’on apprend à ignorer.
Ensuite, remarquez le port IdentityProviderPort. C’est mon réflexe d’architecture hexagonale : le diagnostic ne sait pas quel fournisseur d’identité est derrière, ni comment sa pagination fonctionne. L’adaptateur se charge de dire « complet » ou « partiel », et c’est lui, et lui seul, qui changera le jour où on changera de fournisseur.
L’orchestration : cacher les réponses, jamais les absences de réponse
Et voilà le second garde-fou, celui que j’ai vu rater le plus souvent dans d’autres contextes. Quand le contrôle échoue (réseau, quota, le fournisseur qui tousse), la tentation est énorme de traiter l’échec comme « pas de risque détecté », et de le mettre en cache. Après tout, on n’a rien vu de grave.
Non. Une question restée sans réponse n’est pas une réponse rassurante. C’est exactement le mécanisme que je décrivais dans l’autopsie d’un échec silencieux : le silence n’est pas un succès. Ici, un échec laisse le tampon intact. Le dernier verdict connu reste affiché, ou pas, selon ce qu’il était. Et le prochain démarrage retentera.
async function maybeShowNudge(userId: string, deps: Deps): Promise<boolean> {
  const previous = deps.stamps.read(userId);

  if (previous && isVerdictFresh(previous)) {
    return previous.atRisk; // verdict frais : on affiche le dernier état connu
  }

  // Pré-tampon : on garde le dernier verdict connu, mais on avance l'horodatage.
  // Deux onglets ouverts en parallèle ne dépenseront pas deux fois le budget d'appels.
  deps.stamps.write(userId, { at: Date.now(), atRisk: previous?.atRisk ?? false });

  let diagnosis: Diagnosis;
  try {
    diagnosis = await diagnose(userId, deps.idp);
  } catch {
    // Échec : on restaure le tampon précédent tel quel. Rien n'est affirmé, rien n'est caché.
    if (previous) deps.stamps.write(userId, previous);
    else deps.stamps.clear(userId);
    return previous?.atRisk ?? false;
  }

  if (diagnosis.kind === "inconclusive") {
    // Pas prouvé : même traitement qu'un échec. On n'affiche rien de nouveau.
    if (previous) deps.stamps.write(userId, previous);
    else deps.stamps.clear(userId);
    return previous?.atRisk ?? false;
  }

  const atRisk = diagnosis.kind === "at-risk";
  deps.stamps.write(userId, { at: Date.now(), atRisk });
  return atRisk;
}
Toute cette petite mécanique fait quatre choses, dans l’ordre. Si le tampon est frais, on affiche le dernier verdict sans rien demander à personne. Sinon, on pose un pré-tampon avant l’appel, pour que deux onglets ouverts au même moment ne déclenchent pas deux diagnostics. Puis on interroge. Et selon la réponse : un verdict prouvé remplace le tampon avec sa propre durée de vie ; un échec ou une réponse partielle restaure le tampon précédent, comme si rien ne s’était passé.
Le pré-tampon mérite une remarque. C’est le même problème que dans un compteur ne fait pas un quota : dès qu’un budget est partagé, la vérification et la réservation doivent se faire dans le même geste, sinon deux acteurs passent entre les deux. Ici l’acteur, c’est un onglet, et le budget, c’est le quota d’appels au fournisseur.
Pourquoi pas une autre approche ?
J’aurais pu partir sur d’autres pistes, et je veux vous dire pourquoi je les ai écartées, parce que le raisonnement compte autant que le code.
Un webhook du fournisseur d’identité. L’idéal, évidemment : recevoir un événement « facteur ajouté » et invalider le cache à la source. Sauf que ce signal n’existait pas pour ce parcours d’enrôlement, ou pas de façon fiable. Construire toute la logique sur un signal qu’on ne reçoit pas, c’est construire sur du sable. Et même quand un tel webhook existe, il peut se perdre. La re-vérification périodique reste le filet de sécurité honnête.
Un bouton « j’ai corrigé » sur la bannière. Tentant aussi : l’utilisateur clique, on re-vérifie immédiatement. Je l’ai gardé comme complément, pas comme mécanisme principal. Parce qu’un utilisateur qui ajoute un facteur sur la page du fournisseur ne revient pas forcément cliquer sur votre bannière. Le cache asymétrique fait le travail sans lui demander quoi que ce soit.
Un TTL court pour tout le monde. La solution paresseuse : vingt-quatre heures pour tous les verdicts. Ça règle le problème de l’alerte mensongère, au prix de multiplier par sept les appels chez les utilisateurs sains, qui sont l’immense majorité. C’est exactement l’erreur inverse de la première version : payer cher pour corriger un cas rare, alors qu’on peut ne payer que pour ce cas-là.
Ce que j’en retiens
La durée de vie d’un cache doit refléter le coût d’une croyance périmée, pas une constante unique. Quand deux valeurs possibles n’ont pas le même coût d’erreur, donnez-leur deux TTL. Le mot « politique » est plus juste que le mot « réglage ».
Cachez les réponses, jamais les absences de réponse. Un échec réseau, une liste partielle, un cas hors périmètre : rien de tout ça n’est un « non ». Rien de tout ça ne s’affiche, rien de tout ça ne se met en cache. Le tampon reste intact, et on retentera. C’est la même discipline que pour une mauvaise étape qui ne doit jamais être fatale : distinguer « ça a échoué » de « la réponse est non » est la première chose à faire, pas la dernière.
Quand le chemin de sortie de l’état n’émet aucun signal, la seule stratégie honnête est la re-vérification périodique. Et c’est le verdict pénalisant, celui qui accuse l’utilisateur, qui doit se re-vérifier le plus vite.
Pendant une re-vérification, l’interface garde le dernier état connu. Une alerte de sécurité qui clignote au rythme des requêtes détruit sa propre crédibilité, et celle de toutes les suivantes.
Épilogue
Récapitulons. Une bannière de sécurité qui coûte cher à calculer, donc un cache. Un cache à durée unique, qui faisait mentir l’application pendant six jours chez précisément les gens qui venaient de bien faire. L’asymétrie nommée : un « tout va bien » périmé coûte un peu de retard, un « vous êtes en danger » périmé coûte la confiance. Deux durées de vie, sept jours contre un. Et deux garde-fous : on n’affirme que ce que le serveur a prouvé, et on ne cache jamais une question restée sans réponse.
Vous remarquerez qu’il n’y a pas une ligne de code compliquée là-dedans. Ce qui était compliqué, c’était d’admettre que le TTL n’est pas une constante. C’est une politique, et elle se pense verdict par verdict.
Et vous, avez-vous des caches dans vos applications dont la durée de vie a été choisie au doigt mouillé ? Un statut, un droit, une alerte, quelque chose dont les deux valeurs ne coûtent pas la même chose quand elles sont périmées ? Racontez-moi ça en commentaire, je me ferai une joie de vous répondre, et de découvrir vos propres asymétries.