Table des matières
Ouvrir table des matières
Un aveu pour commencer
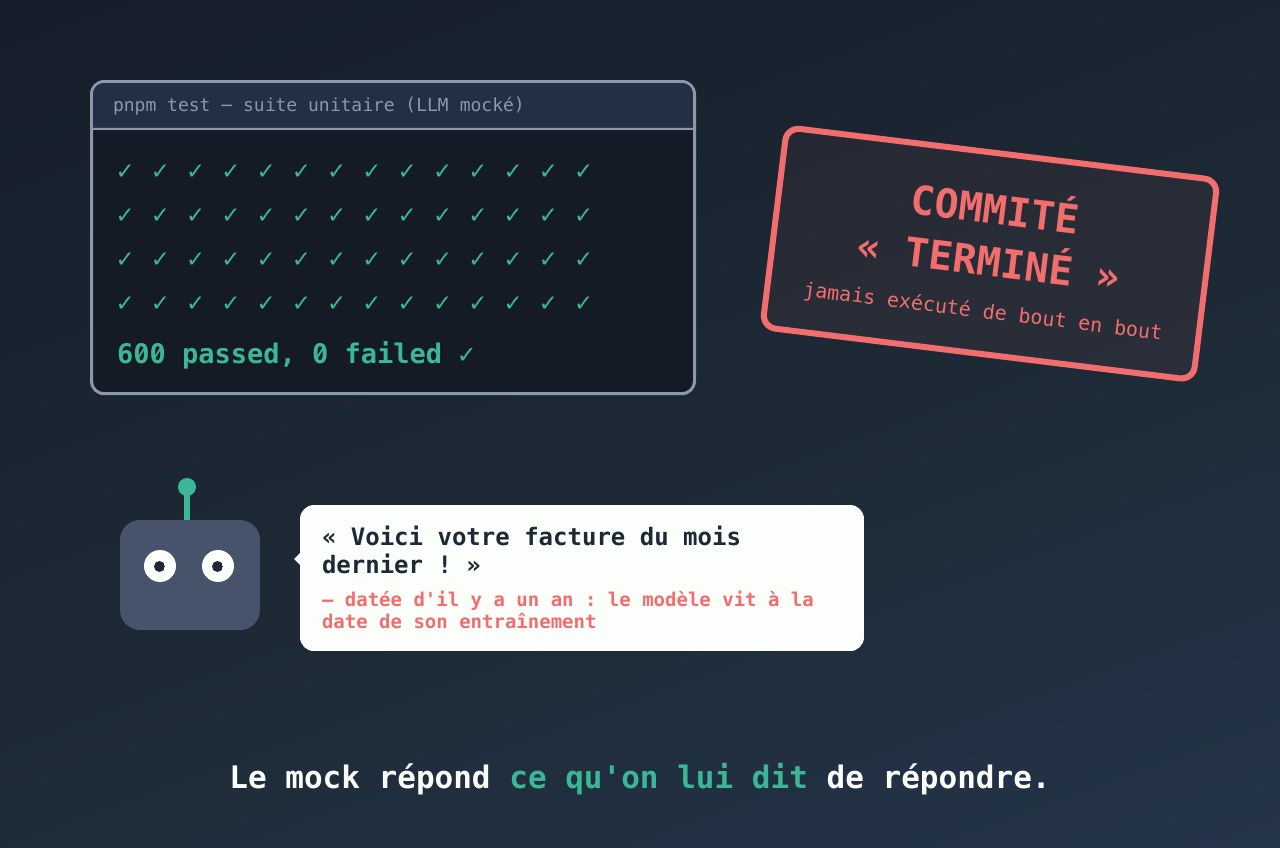
Laissez-moi vous faire un aveu qui pique un peu. Sur mon agent local — une boucle ReAct avec un orchestrateur multi-agents, environ 600 tests unitaires, une hygiène de code dont j’étais plutôt fier — trois fonctionnalités d’orchestration ont été commitées « terminées ». Parallélisation des étapes indépendantes, vérification du livrable final, traçabilité des contextes injectés. Tests écrits, suite verte, commits propres. Le travail bien fait, quoi.
Puis vient une campagne de test en conditions réelles : l’application lancée pour de vrai, les vrais modèles, une tâche qu’un utilisateur réel poserait. Et là, le constat gênant : l’application n’avait jamais exécuté ces trois chemins de bout en bout. Jamais. Six cents tests verts, trois fonctionnalités « terminées »… et un logiciel qui n’avait jamais fait ce qu’on venait de déclarer qu’il faisait.
Un comble pour quelqu’un qui écrit des articles sur les tests, me direz-vous. Justement : c’est parce que la suite était sérieuse que le constat est intéressant. Le problème n’était pas un manque de tests — c’était une famille entière de bugs que ces tests ne peuvent pas voir, par construction. Cet article raconte laquelle, avec le bug le plus savoureux de ma carrière récente en vedette : un agent persuadé de vivre à la date de son corpus d’entraînement.
Deux familles de bugs, et elles ne se recouvrent pas
Posons le cadre, parce qu’il dépasse largement mon projet. Sur une application pilotée par un LLM, il existe deux familles de bugs disjointes :
- Les bugs de votre logique. Le routage qui envoie la tâche au mauvais agent, le budget mal décompté, l’enchaînement d’étapes cassé, le format de sortie mal parsé. Vos tests unitaires à LLM mocké les attrapent très bien — c’est leur métier, et mes 600 tests le faisaient consciencieusement.
- Les bugs du comportement du modèle. L’hallucination temporelle, la conclusion prématurée, la fabrication assurée. Ceux-là, vos tests mockés ne les verront jamais. Pas par paresse, pas par manque de cas : par construction. Un mock répond ce qu’on lui dit de répondre — il simule votre hypothèse sur le modèle, pas le modèle.
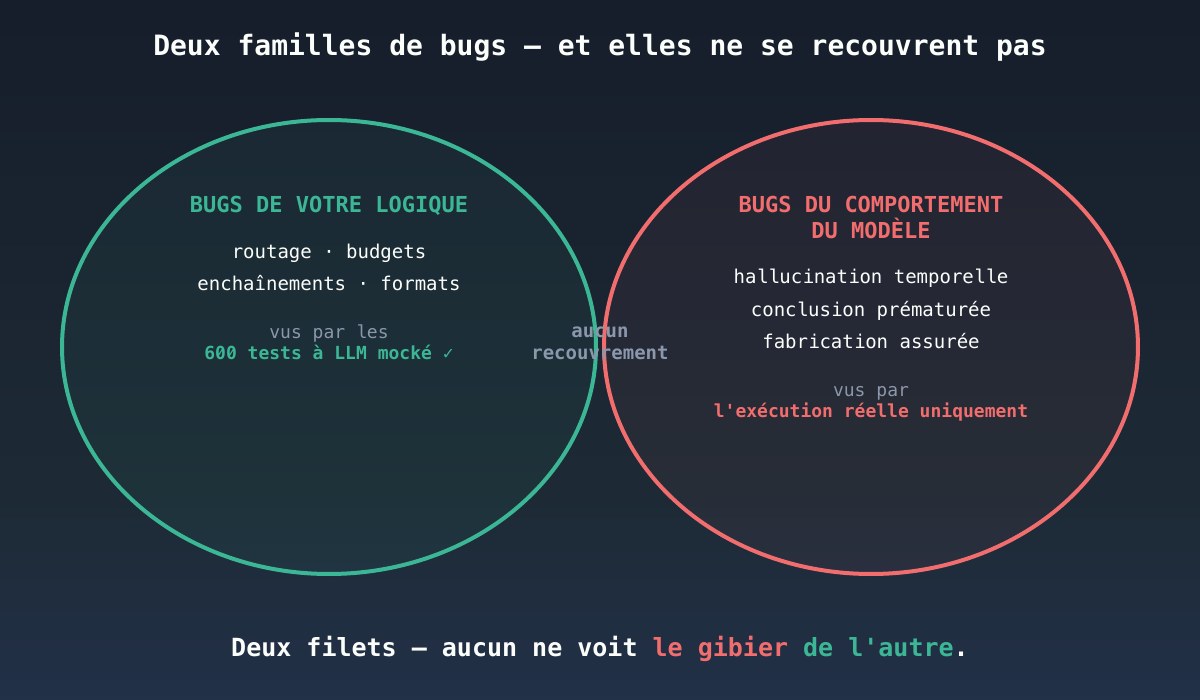
Relisez la deuxième famille : elle est invisible à toute suite unitaire, aussi grosse soit-elle. Vous pouvez passer de 600 à 6 000 tests mockés, la couverture de cette famille restera exactement zéro. C’est le prolongement direct de ce que je racontais dans ce que ni les tests unitaires ni les E2E ne voient — sauf qu’ici, le filet manquant n’est pas une campagne de charge : c’est l’exécution réelle, tout simplement.
Et devinez ce que la campagne réelle a trouvé, immédiatement, sur ces trois chemins jamais exécutés ? Des bugs. Tous de la seconde famille. Dont celui-ci.
Le bug emblématique : l’agent vivait à la date de son entraînement
La demande utilisateur, banale entre toutes : « retrouve ma facture du mois dernier ».
L’agent s’exécute, fouille, répond — plausible, assuré, précis. Et complètement faux : la facture désignée datait d’une époque antérieure d’un an. Pas une erreur de recherche, pas un fichier manquant. Un problème de calendrier.
Alors, pourquoi ? Prenez trois secondes avant de lire la réponse, elle vaut le détour. Mon prompt système ne contenait pas la date du jour. Or un modèle de langage n’a pas d’horloge : figé au moment de son entraînement, il ne « sait » l’heure qu’il est que si on la lui dit. Face à « le mois dernier », il a donc résolu l’expression depuis la seule information temporelle en sa possession — son corpus d’entraînement. De son point de vue, il vivait un an plus tôt, et sa réponse était parfaitement cohérente… dans son monde.
Ce qui rend ce bug précieux, c’est qu’il est structurellement invisible aux tests mockés. Le mock du LLM répond ce que le test lui fait répondre : il ne va pas spontanément halluciner une date d’il y a un an. Pour rencontrer ce bug, il faut le vrai modèle, le vrai prompt assemblé, la vraie question d’utilisateur. Exactement ce que la suite verte ne fait jamais.
Le correctif est trivial ; son réglage ne l’est pas
La correction tient en trois lignes dans le prompt système :
## Date du jour
Nous sommes <jour-de-semaine> <AAAA-MM-JJ>.
Toute expression relative (« hier », « le mois dernier »)
se calcule à partir de cette date.
Trivial, n’est-ce pas ? Attendez la suite, parce que le réglage de ce correctif est la partie la plus intéressante de l’article.
La question qui ne se pose pas au premier abord : à quel grain injecter cette date ? Le réflexe complétiste dirait date + heure + minute — plus d’information, mieux c’est, non ? Eh bien non, et pour une raison d’infrastructure : le cache de prompt. Les serveurs d’inférence mettent en cache les préfixes de prompt déjà traités ; tant que le début de votre prompt système est identique à l’octet près, les appels suivants réutilisent le calcul précédent — et c’est un gain majeur quand une boucle d’agent rejoue le même prompt système des dizaines de fois. Injectez l’heure courante, et chaque appel a un préfixe différent : cache froid en permanence, pour un « bénéfice » que rien dans le besoin ne réclamait.
D’où la règle, qui vaut bien au-delà des dates : le contexte dynamique s’injecte au grain le plus grossier qui suffit au besoin. « Le mois dernier » se résout au jour près — alors on injecte le jour, jamais l’heure. Le préfixe du prompt reste ainsi byte-identique pendant toute une journée d’exécutions, et le cache reste chaud. Une phrase de prompt, deux contraintes réconciliées : la justesse temporelle et la performance. C’est le même genre d’arbitrage discret que le réglage du thinking par étage : invisible dans une démo, décisif sur une boucle qui enchaîne les appels.
La règle de process qui en est sortie
Reste la question de fond : comment trois fonctionnalités « terminées » ont-elles pu ne jamais avoir tourné ? La réponse honnête : parce que rien, dans mon process, n’exigeait qu’elles tournent. Les tests passaient, le code était relu, la définition de « terminé » était satisfaite… et cette définition ne contenait pas « l’application l’a réellement fait ».
La correction n’est pas technique, elle est rituelle. Une règle dure, écrite noir sur blanc dans les conventions du projet :
Avant de déclarer un correctif ou une fonctionnalité « terminé » : exécuter le chemin touché dans l’application réelle, sur les vrais modèles, avec une tâche qu’un utilisateur réel donnerait — et lire les vraies sorties : la trace, les fichiers produits, le livrable final.
Chaque mot est pesé, et j’insiste sur le piège du milieu : un script de test ad hoc qui appelle les mêmes fonctions n’est pas un substitut. Il ne passe pas par l’assemblage réel du prompt, l’historique réel de la conversation, les vrais enchaînements d’étapes — il re-teste votre logique en croyant tester le système. Les spikes et scripts de mesure gardent leur place (mesurer un internal, isoler un comportement), mais en complément du chemin réel, jamais à la place.
Est-ce que ça vaut le coût ? Voici mon critère, et je vous le donne parce qu’il est réutilisable tel quel : depuis cette règle, chaque campagne réelle a trouvé au moins un bug de la famille « comportement modèle », invisible à la suite unitaire. Tant que c’est le cas, la règle prouve à chaque passage qu’elle teste autre chose que les tests — le jour où les campagnes reviendront bredouilles plusieurs fois de suite, je pourrai en alléger la cadence, chiffres en main.
Bien entendu, cette règle ne remplace pas la suite unitaire — les 600 tests attrapent l’autre famille, celle des régressions de logique, et je reste convaincu de leur valeur. Les deux filets couvrent deux familles disjointes : il en faut deux, précisément parce qu’aucun ne voit le gibier de l’autre.
Ce que j’en retiens
Un LLM mocké teste votre logique, jamais le modèle. Routage, budgets, formats d’un côté ; hallucinations temporelles, conclusions prématurées, fabrications de l’autre. Les deux familles sont disjointes, et une suite verte — même grosse, même soignée — ne dit strictement rien sur la seconde.
Le modèle n’a pas d’horloge. Toute expression temporelle relative, sans date injectée dans le prompt, sera résolue depuis l’époque du corpus d’entraînement — de façon silencieusement plausible, donc dangereuse. « Plausible et faux », c’est la signature de toute cette famille de bugs : rien ne crashe, tout a l’air bien.
Injectez le contexte dynamique au grain le plus grossier qui suffit. La date au jour près, pas à l’heure : le préfixe de prompt reste byte-identique sur la journée, le cache de prompt reste chaud. Chaque octet de contexte dynamique a un coût d’infrastructure — ne payez que ceux que le besoin exige.
Ritualisez la validation « chemin réel ». Une règle explicite dans les conventions du projet — pas une bonne intention — exigeant l’exécution dans l’application réelle avant tout « terminé ». C’est elle, et elle seule, qui attrape la famille de bugs que les tests ne voient pas. Une bonne intention s’érode en trois sprints ; une règle écrite se relit à chaque revue.
Épilogue
Récapitulons le voyage : 600 tests verts, trois fonctionnalités « terminées » que l’application n’avait jamais exécutées, et une campagne réelle qui trouve immédiatement ce que les mocks ne peuvent pas voir — un agent qui vivait, en toute confiance, à la date de son entraînement. Les sorties : une ligne de prompt réglée au bon grain pour ne pas sacrifier le cache, et surtout une règle de process qui redéfinit « terminé » comme « l’application l’a réellement fait, et j’ai lu les vraies sorties ».
Ce que cette histoire m’a appris de plus général : quand un composant probabiliste entre dans votre système, votre définition de « testé » doit s’élargir avec lui. La mécanique se prouve en unitaire ; le comportement se constate en réel. Confondre les deux, c’est être fier de sa suite verte pendant que l’agent répond à côté — avec aplomb, en plus. D’ailleurs, si le sujet des pannes réelles de boucles d’agents vous intéresse, mes quatre règles de retry sont nées exactement du même réflexe : lire les traces de ce qui s’est vraiment passé.
Et vous, quelle est la définition de « terminé » sur vos projets LLM ? Vos mocks vous ont-ils déjà fait déclarer fini quelque chose qui n’avait jamais tourné — ou votre agent a-t-il déjà répondu depuis une autre époque ? Racontez-moi ça en commentaire, je me ferai une joie de vous répondre.